AI-onderzoeker leert van zijn eigen werk en bedenkt steeds betere hypotheses
Het jonge bedrijf PhAI Labs bouwde een team van AI-agents dat onderzoeksideeën bedenkt, toetst en bijhoudt wat werkte. Van dat verslag leert het systeem, waardoor zijn hypotheses na twee rondes beter werden. Code en model staan openbaar online.
Een goed idee is het begin van elk onderzoek. Maar van een idee naar een experiment dat echt iets bewijst, is een lange weg. Een onderzoeker moet een vermoeden zo scherp maken dat het te toetsen is, bedenken welke gegevens daarvoor nodig zijn en vooraf vastleggen wanneer het idee fout blijkt. Dat kost veel tijd, en veel ideeën sneuvelen onderweg.
Het jonge AI-bedrijf PhAI Labs, met onder anderen Ling Yang van de Amerikaanse Princeton University als medeoprichter, presenteert nu een systeem dat dit werk zelf doet en er gaandeweg beter in wordt. Het heet DiscoveryRSI. Het verslag van het onderzoek, met 24 auteurs, staat sinds 16 oktober 2026 online.
Een boom vol ideeën
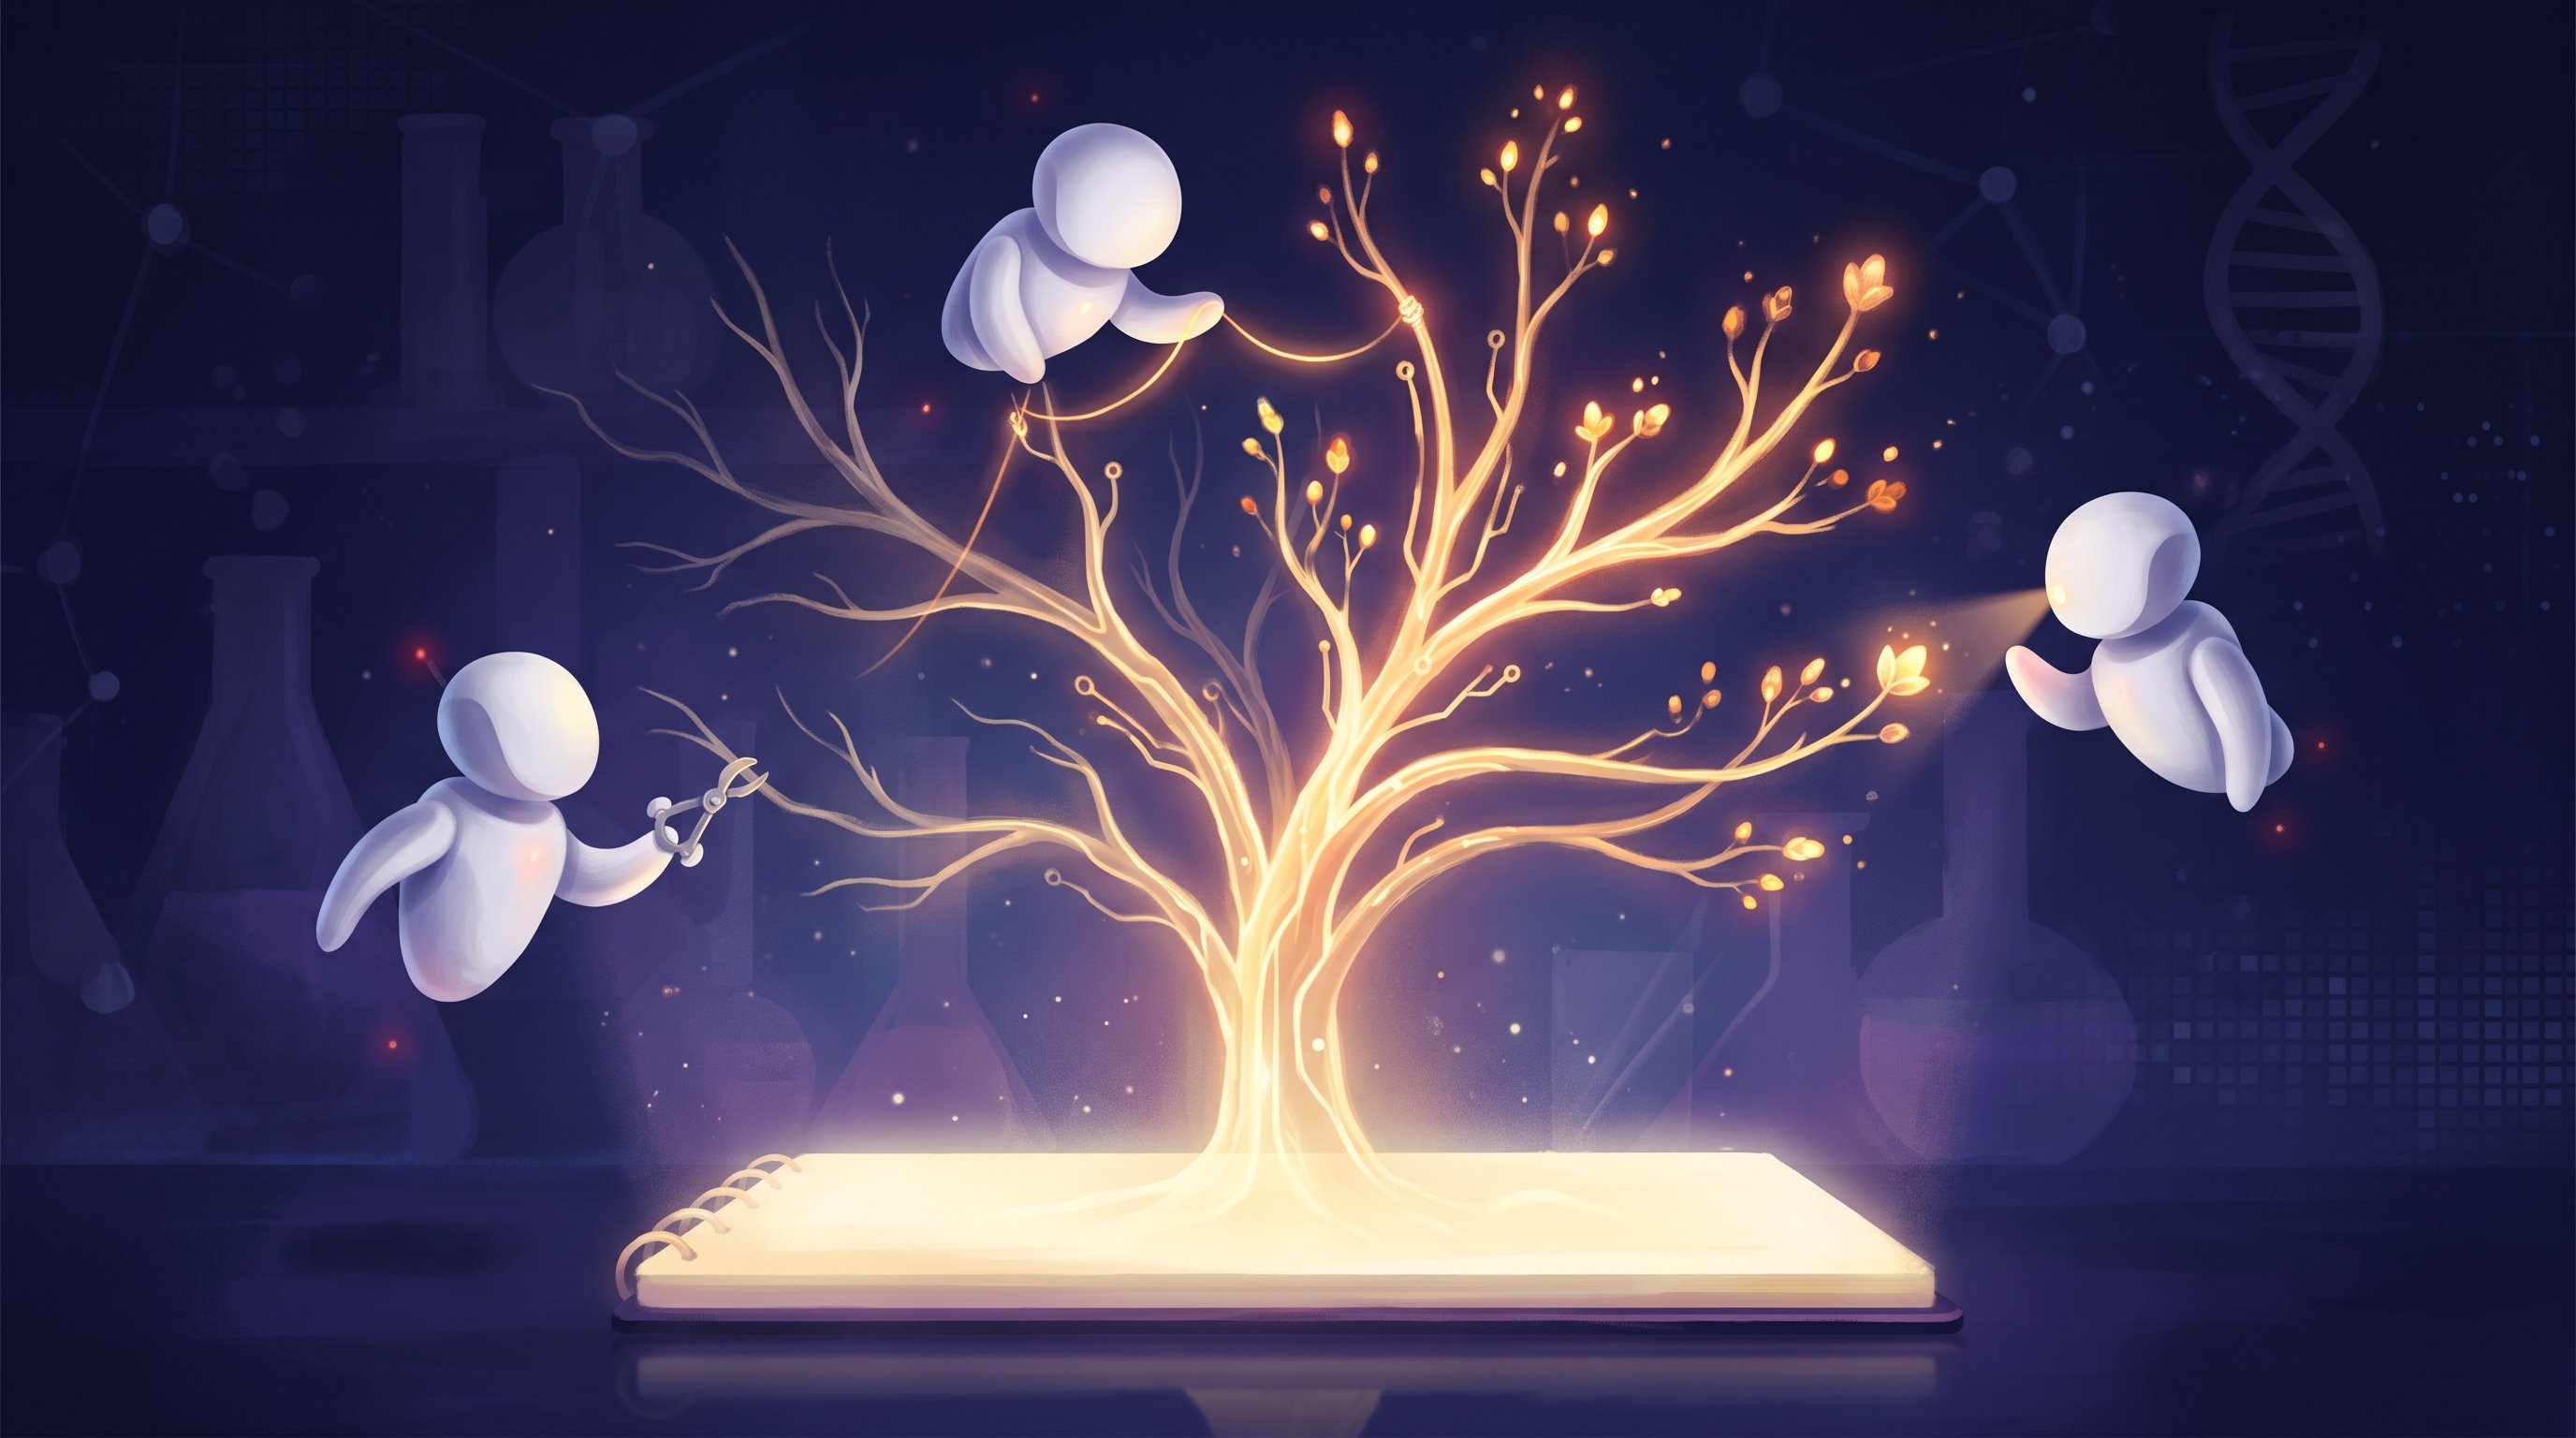
Het systeem werkt met een team van AI-agents: AI-programma's die zelfstandig taken uitvoeren. Een leidende agent coördineert de rest. Samen laten ze een vermoeden groeien als een boom. Een idee wordt aangepast, gerepareerd, gecombineerd met een ander idee of juist opnieuw begonnen. Bij elke nieuwe versie geeft een andere agent kritiek. De beste takken blijven over.
Een gekozen idee wordt daarna omgezet in een concrete opdracht die een computer kan uitvoeren, met de gegevens, de stappen en de controles erbij. Zo blijft een hypothese geen los idee, maar wordt het iets wat je echt kunt testen.
Leren van het eigen logboek
Het bijzondere zit in wat er daarna gebeurt. Het systeem houdt een logboek bij: welk bewijs er was, welke keuzes werden gemaakt en welke agent wat bijdroeg. Van dat logboek leert het op twee manieren.
Ten eerste kijkt het welke stappen tot een goede beoordeling leidden, en traint het daarmee een eigen AI-model, DiscoveryRSI-27B. Ten tweede speelt het eerdere rondes opnieuw af om te zien welke aanpak werkte en waar het steeds misging. Daarmee past het de werkwijze aan. Met het verbeterde model en de nieuwe werkwijze begint het aan nieuwe vragen. Zo leert het van zijn eigen ervaring, net als een onderzoeker die na elk project slimmer wordt.
Wat het oplevert
De onderzoekers testten het systeem op vier gebieden binnen de biologie en geneeskunde. Na twee rondes van zelfverbetering kregen de hypotheses volgens hun eigen beoordelingssysteem een hoger cijfer: van 4,86 naar 5,39. De grootste winst zat in de toetsbaarheid: kun je het idee echt weerleggen, en zijn de benodigde gegevens te vinden?
Een tweede test is slim bedacht. De onderzoekers keken of het model ideeën bedacht die later echt door wetenschappers zijn onderzocht, in artikelen die verschenen nadat het model was getraind. Bij hun eigen model gold dat voor 6,3 procent van de ideeën. Bij GPT-6 Luna van OpenAI was dat 2,5 procent en bij Claude Opus 5 van Anthropic 2,3 procent.
Daarnaast beoordeelden 27 deskundigen 292 voorstellen, zonder te weten welk systeem ze had gemaakt. In deze eerste ronde vonden ze de ideeën van DiscoveryRSI belangrijker en beter onderbouwd dan die van GPT-6 Luna.
Het systeem heeft nog geen ontdekking gedaan die in het lab is bevestigd. Dat een idee lijkt op later onderzoek, laat zien dat het de goede kant op denkt, maar niet dat het de echte wetenschappers heeft geholpen. De volgende stap is dat onderzoekers de beste ideeën echt gaan testen. De code, het model en voorbeelden staan gratis online, zodat anderen het systeem kunnen controleren en verder kunnen bouwen.
Wat betekent dit voor de weg naar de singulariteit?
Een AI die van zijn eigen werk leert en daardoor beter wordt, is precies het soort stap waar de singulariteit over gaat. Het is hier nog kleinschalig: twee rondes, een beperkte winst, en de beoordeling komt voor een groot deel van een AI-systeem zelf. Maar het principe werkt.
Een groot taalmodel kent alle vakgebieden tegelijk. Combineer je dat met een systeem dat leert welke ideeën te toetsen zijn en welke niet, dan kan het verbanden voorstellen die een specialist in één vak niet snel ziet. Als zulke AI-onderzoekers straks ook zelf proeven kunnen laten uitvoeren en van de uitkomsten leren, kan de wetenschap een flinke versnelling krijgen.