English
ImageNet: 3,2 miljoen foto's, met de hand gesorteerd, om computers te leren zien
Het team van Fei-Fei Li presenteert ImageNet, een database met 3,2 miljoen foto's in 5.247 categorieën, door mensen gecontroleerd. Het is de grootste schone fotoverzameling voor onderzoekers die computers beelden willen leren herkennen.
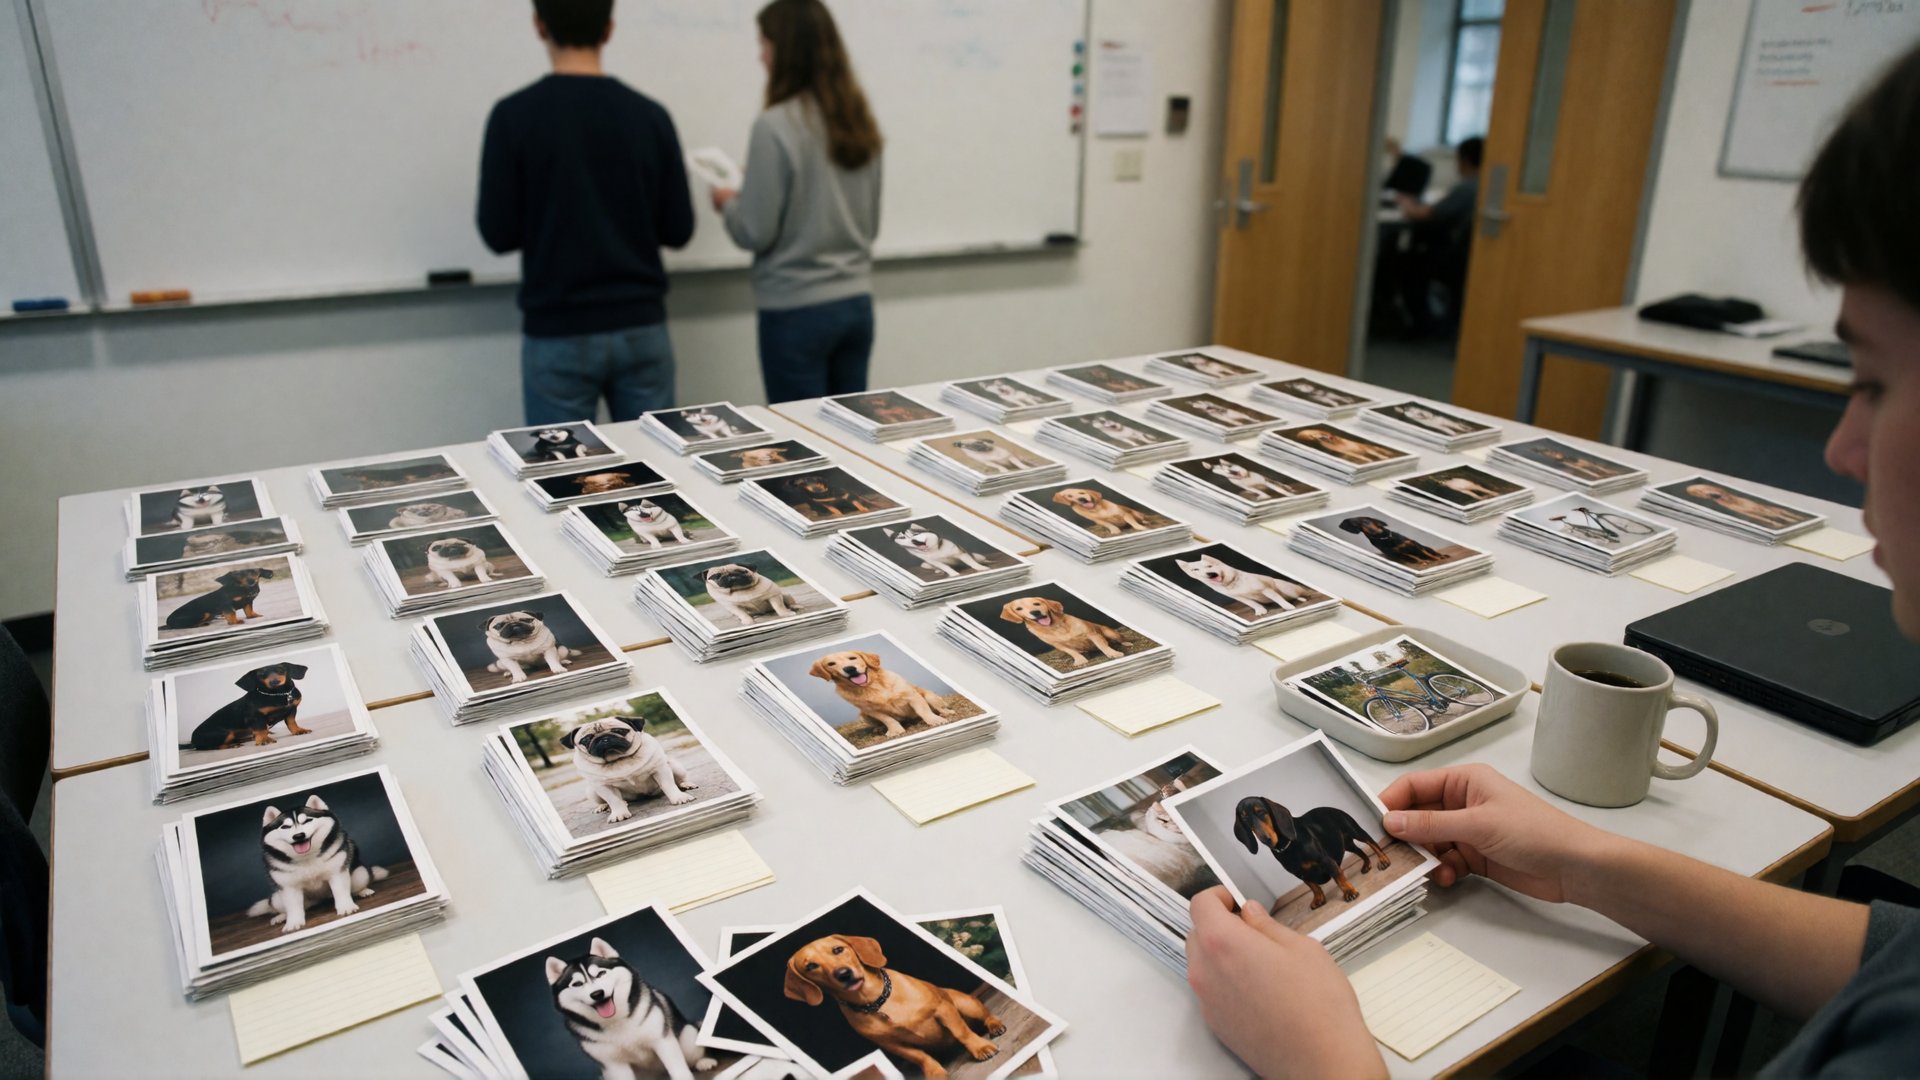
PRINCETON, JUNI 2009 - Onderzoekers van Princeton University presenteren op de conferentie CVPR, het vakcongres voor computers die beelden begrijpen, een nieuwe database: ImageNet. Het team van Li Fei-Fei beschrijft een verzameling van 3,2 miljoen foto's in 5.247 categorieën, met de hand gecontroleerd. Volgens de makers is het de grootste schone fotoverzameling die onderzoekers kunnen gebruiken, in aantal foto's, in foto's per categorie en in aantal categorieën. Het doel is nog veel groter: ongeveer 50 miljoen foto's binnen twee jaar.
Waarom voorbeelden nodig zijn
Een computer herkent een hond niet doordat iemand hem uitlegt hoe een hond eruitziet. Hij leert het van voorbeelden: duizenden foto's waar 'hond' bij staat. Hoe meer, en hoe gevarieerder, hoe beter hij leert. Zulke verzamelingen waren tot nu toe klein, of vol fouten. Op internet staan inmiddels miljarden foto's, maar zonder bijschrift weet de computer niet wat erop staat.
Stap 1: kies de categorieën
ImageNet gebruikt de indeling van WordNet, een woordenboek dat zo'n 80.000 zelfstandige naamwoorden ordent in groepen van betekenis en in een boomstructuur. Onder 'zoogdier' hangt bijvoorbeeld 'hond', daaronder 'werkhond' en daaronder 'husky'. Elk blad van die boom wordt een categorie. De indeling is zo fijn dat er 147 soorten honden in zitten, iets wat geen eerdere verzameling heeft.
Stap 2: verzamel kandidaten
Per categorie vragen de onderzoekers beeldzoekmachines op internet om foto's. Dat levert veel rommel op: gemiddeld is maar ongeveer 10 procent van de zoekresultaten goed. Daarom halen ze er veel van op, gemiddeld meer dan 10.000 per categorie, en zoeken ze ook met vertalingen van het woord in het Chinees, Spaans, Nederlands en Italiaans.
Stap 3: laat mensen sorteren
Daarna kijken mensen elke foto na, via Amazon Mechanical Turk. Dat is een website waar je kleine klusjes kunt plaatsen die anderen tegen betaling uitvoeren. De mensen krijgen een stapel foto's en de omschrijving van de categorie, en zeggen of de foto erbij hoort. Omdat mensen fouten maken en het soms oneens zijn, kijken meerdere mensen onafhankelijk naar dezelfde foto. Een foto telt pas mee als een duidelijke meerderheid ja zegt. Voor makkelijke categorieën als 'kat' zijn minder stemmen nodig dan voor 'Birmaanse kat'. De onderzoekers laten eerst minstens tien mensen stemmen over een steekproef, en berekenen daarmee hoeveel stemmen elke categorie nodig heeft.
De proef op de som: bij een steekproef van 80 categorieën bleek gemiddeld 99,7 procent van de foto's goed gesorteerd.
Teruggeblikt vanuit 2026
Het sorteren duurde tot april 2010. Sinds 2010 hield het ImageNet-team een jaarlijkse wedstrijd met een deel van de verzameling: 1.000 categorieën en ruim 1,2 miljoen foto's om van te leren. In 2012 won AlexNet die wedstrijd met een neuraal netwerk, met bijna 11 procentpunten minder fouten dan de nummer twee. Dat zette het idee van deep learning op de kaart. De wedstrijd stopte na 2017, omdat de taak als opgelost gold. ImageNet zelf telt nu meer dan 14 miljoen foto's in meer dan 20.000 categorieën.
ImageNet laat zien dat voor goede AI niet alleen slimme rekenregels nodig zijn, maar ook veel zorgvuldig gesorteerd voorbeeldmateriaal. Latere stappen hebben dat voorbeeld gevolgd: eerst de data op orde, dan het netwerk.