English
Netwerk van kunstmatige neuronen leert van zijn eigen fouten
Drie onderzoekers beschrijven in Nature een leermethode voor kunstmatige neurale netwerken: het netwerk rekent zijn fout terug en stelt alle verbindingen een klein beetje bij. Zo vinden ook de tussenlagen zelf wat voor de taak belangrijk is.
LONDEN, OKTOBER 1986 - Het tijdschrift Nature publiceert een kort artikel van David Rumelhart, Geoffrey Hinton en Ronald Williams over een manier om een netwerk van kunstmatige neuronen te laten leren van zijn eigen fouten. De methode heet back-propagation, vrij vertaald: de fout terugrekenen.
Een netwerk van kleine rekenkastjes
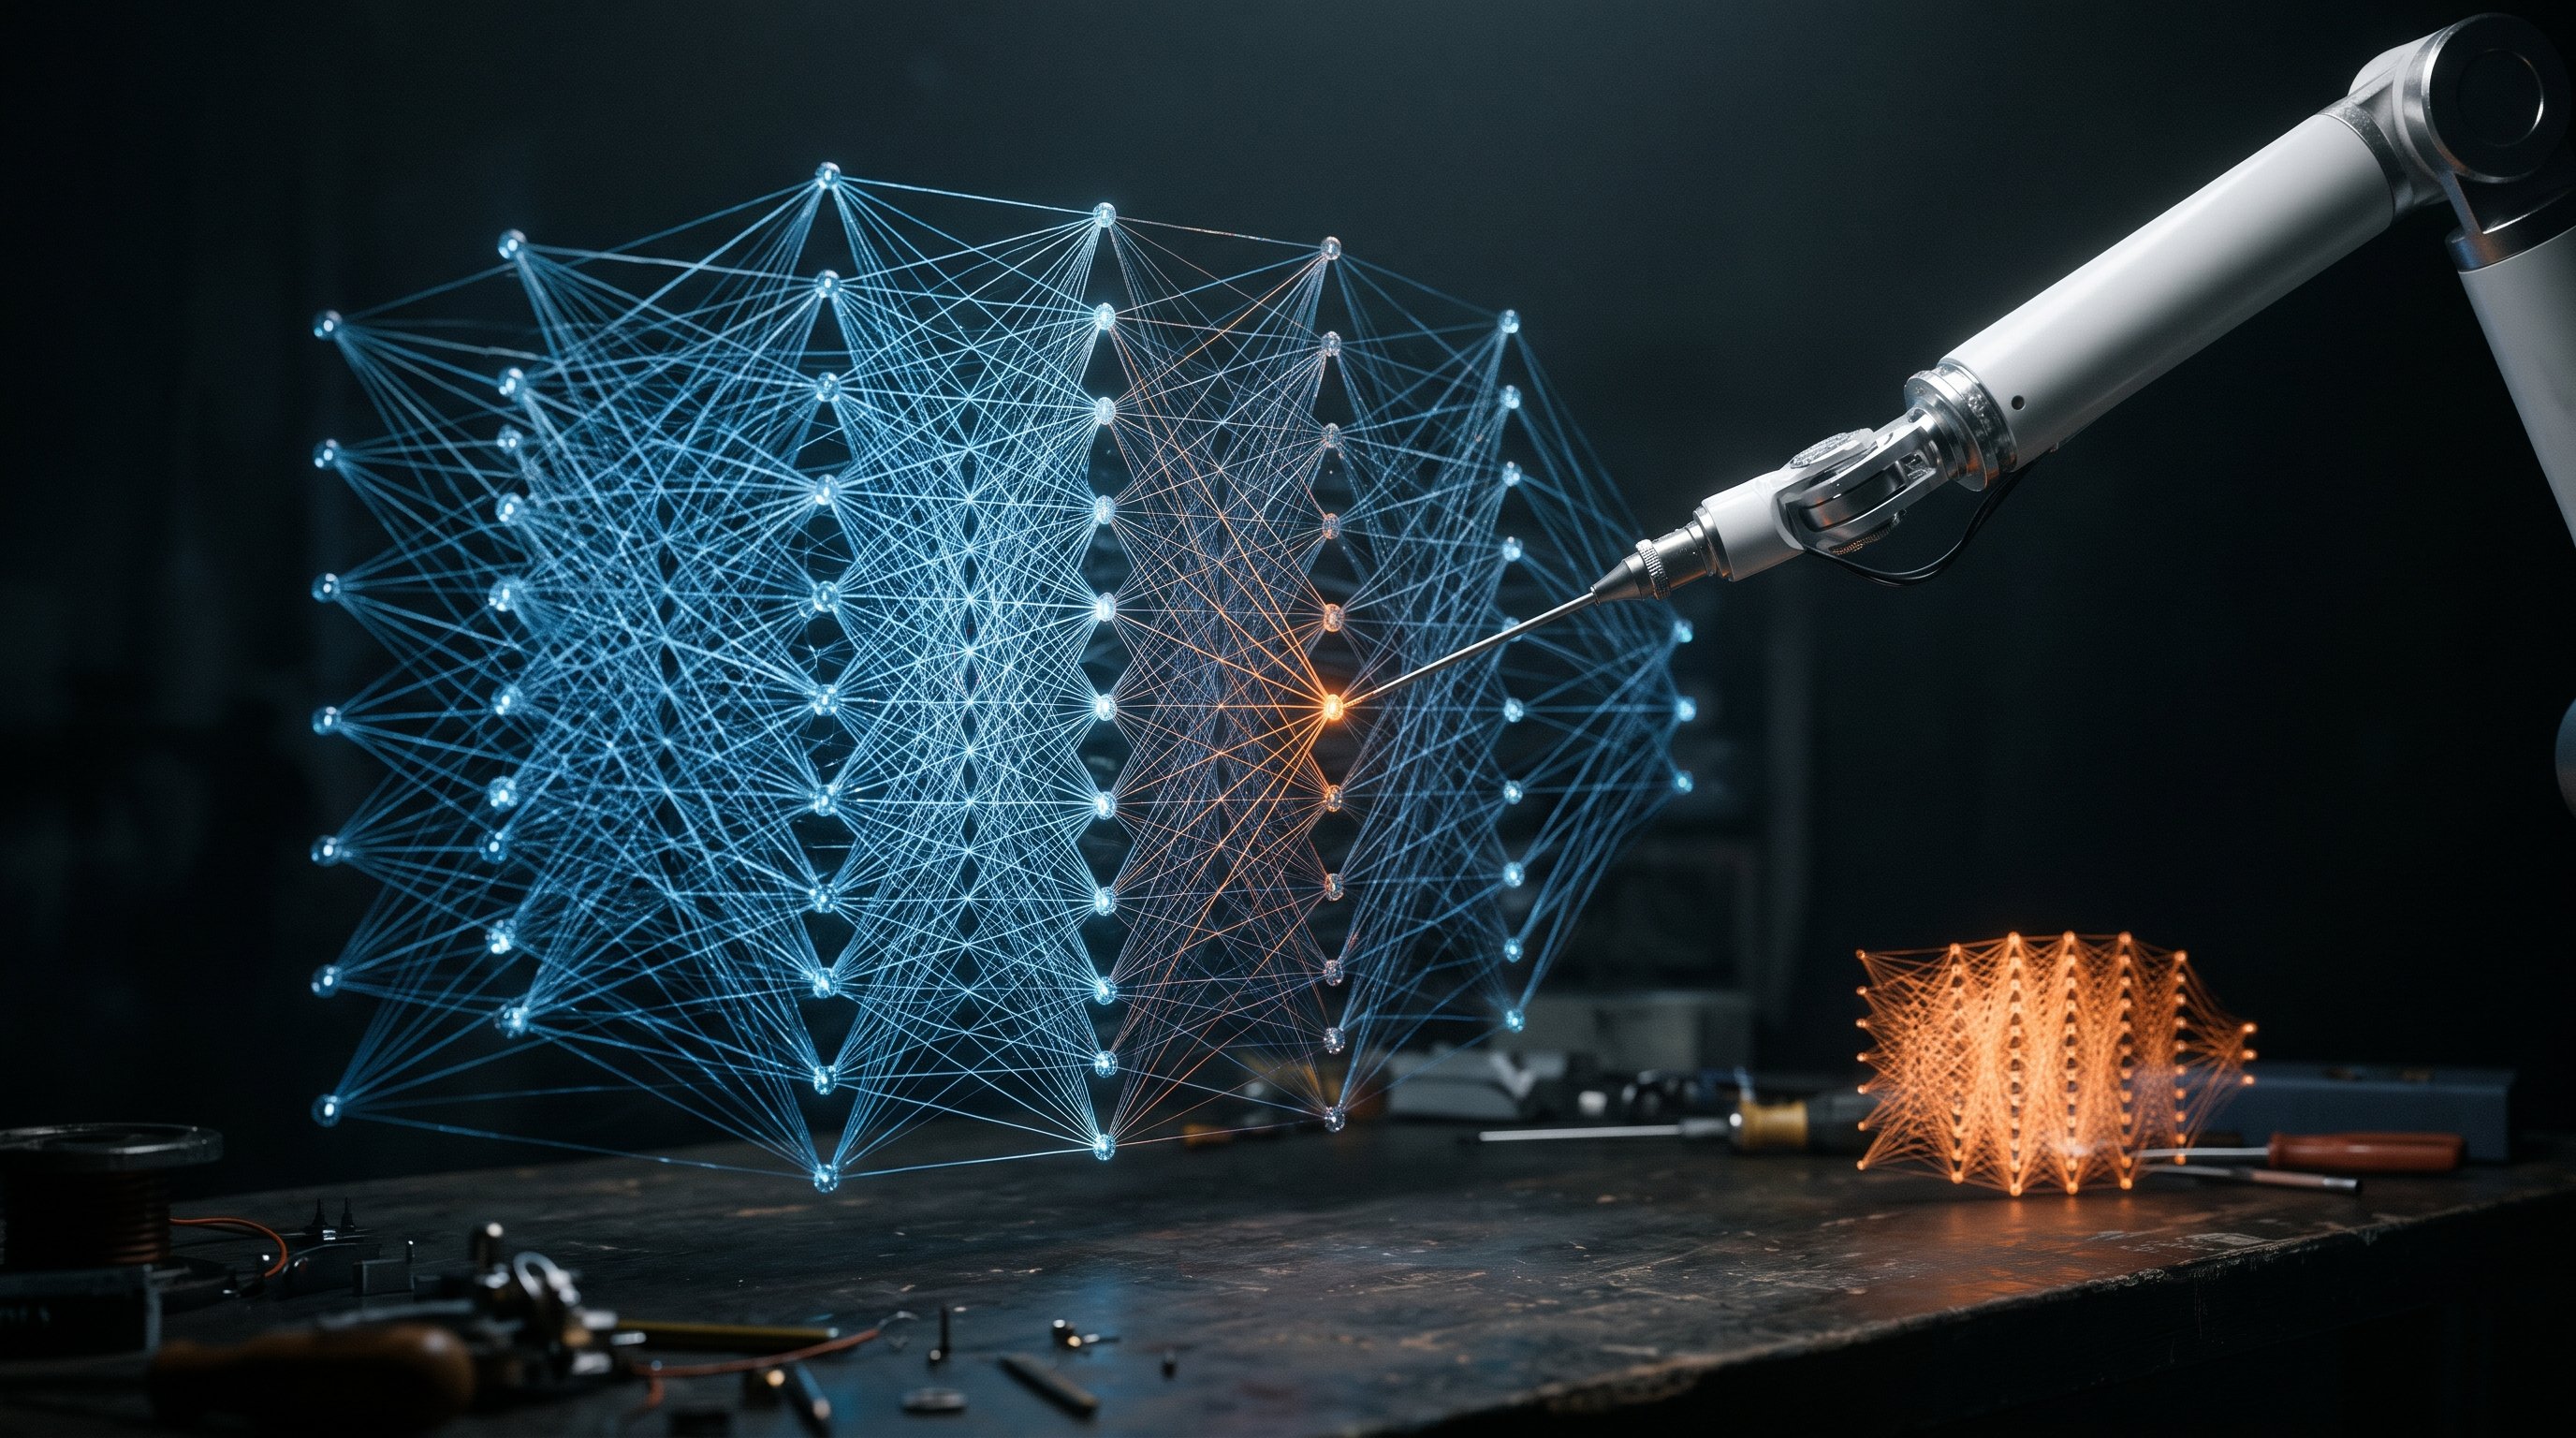
Een kunstmatig neuraal netwerk is een computerprogramma dat losjes naar de hersenen is gemodelleerd. Het bestaat uit lagen van eenvoudige eenheden, de kunstmatige neuronen. Elke eenheid krijgt getallen binnen van de eenheden uit de laag ervoor. Elke verbinding heeft een sterkte: het getal dat erdoorheen gaat, wordt met die sterkte vermenigvuldigd. De eenheid telt alles op en geeft de uitkomst door aan de volgende laag. Vooraan gaat de invoer erin, bijvoorbeeld de lichtwaarden van een plaatje. Achteraan komt het antwoord uit, bijvoorbeeld wat er op het plaatje staat.
Wat zo'n netwerk doet, hangt dus helemaal af van die sterktes. Niemand schrijft regels voor. De goede sterktes moeten door het netwerk zelf worden gevonden.
Leren is bijstellen
Dat gaat zo. Je laat het netwerk een voorbeeld zien waarvan je het goede antwoord kent. Het geeft zijn eigen antwoord, en het verschil met het goede antwoord is de fout. Daarna stel je alle sterktes een klein beetje bij, zodat de fout bij dit voorbeeld kleiner wordt. Dat herhaal je met veel voorbeelden.
Vergelijk het met een mengtafel met honderden knoppen, waarbij het geluid niet klopt. Per knop wil je weten: moet hij iets hoger of lager, en hoeveel? De knoppen zijn de verbindingssterktes en het geluid is het antwoord van het netwerk.
Waar het lastig wordt
Bij de verbindingen vlak voor de uitvoer is dat te doen, want daar zie je direct hoe elke sterkte de fout beïnvloedt. Maar tussen invoer en uitvoer zitten verborgen lagen. Voor die eenheden bestaat geen goed antwoord dat je kunt nagaan, dus je weet niet wat ze moeten doen. Eenvoudiger leerregels uit de tijd ervoor werken alleen bij netwerken zonder zulke tussenlagen.
Terugrekenen, laag voor laag
De nieuwe methode begint achteraan, waar de fout te zien is. Eerst rekent ze uit hoeveel elke eenheid in de laatste laag aan die fout bijdraagt. Daarmee kan ze de laag daarvoor doorrekenen, en zo gaat ze laag voor laag terug naar de invoer. Bij elke stap gebruikt ze wat ze net heeft uitgerekend, dus het werk hoeft niet steeds opnieuw. Per verbinding komt er een getal uit: wordt deze sterkte iets groter, dan wordt de fout groter of kleiner, en met hoeveel. Dat is precies wat je bij de knoppen wilde weten.
Daarna volgt de bijstelling zelf. Elke sterkte gaat een klein stapje in de richting waarin de fout kleiner wordt. De methode doet dit in kleine stappen en met veel voorbeelden, tot de fout klein genoeg is.
Wat het oplevert
De onderzoekers schrijven dat de verborgen eenheden daardoor zelf belangrijke kenmerken van de taak gaan voorstellen, ook al heeft niemand dat voorgeschreven. Het netwerk vindt dus zijn eigen tussenstappen. Dat onderscheidt de methode van de eenvoudiger leerregels van eerder.
Teruggeblikt vanuit 2026
Het idee kwam niet uit het niets. De onderzoeker Seppo Linnainmaa beschreef de rekenmethode achter het terugrekenen al in 1970, en Paul Werbos paste haar in 1982 toe op netwerken met meerdere lagen. Rumelhart bedacht de methode rond dezelfde tijd zelfstandig. Het artikel uit 1986 zorgde ervoor dat ze algemeen bekend werd.
Sindsdien worden vrijwel alle moderne AI-modellen op deze manier getraind, tot en met de grootste taalmodellen. Voor grote netwerken zijn wel heel veel voorbeelden en rekenkracht nodig, en die kwamen pas later. In 2012 trainde een team in Toronto een netwerk met 60 miljoen verbindingssterktes op grafische chips en won daarmee een wedstrijd in beeldherkenning. Zo werd een methode uit 1986 de motor van de huidige AI.