Onderzoeker zegt: het binnenwerk van AI is veel beter te begrijpen dan we dachten
Nick Cammarata van het AI-bedrijf Goodfire stelt dat de 'neuronen' in AI-modellen meestal één duidelijke taak hebben. Als dat klopt, wordt het veel makkelijker om in een AI-model te kijken en te controleren wat het doet. Andere experts noemen het werk interessant, maar willen eerst meer bewijs zien.
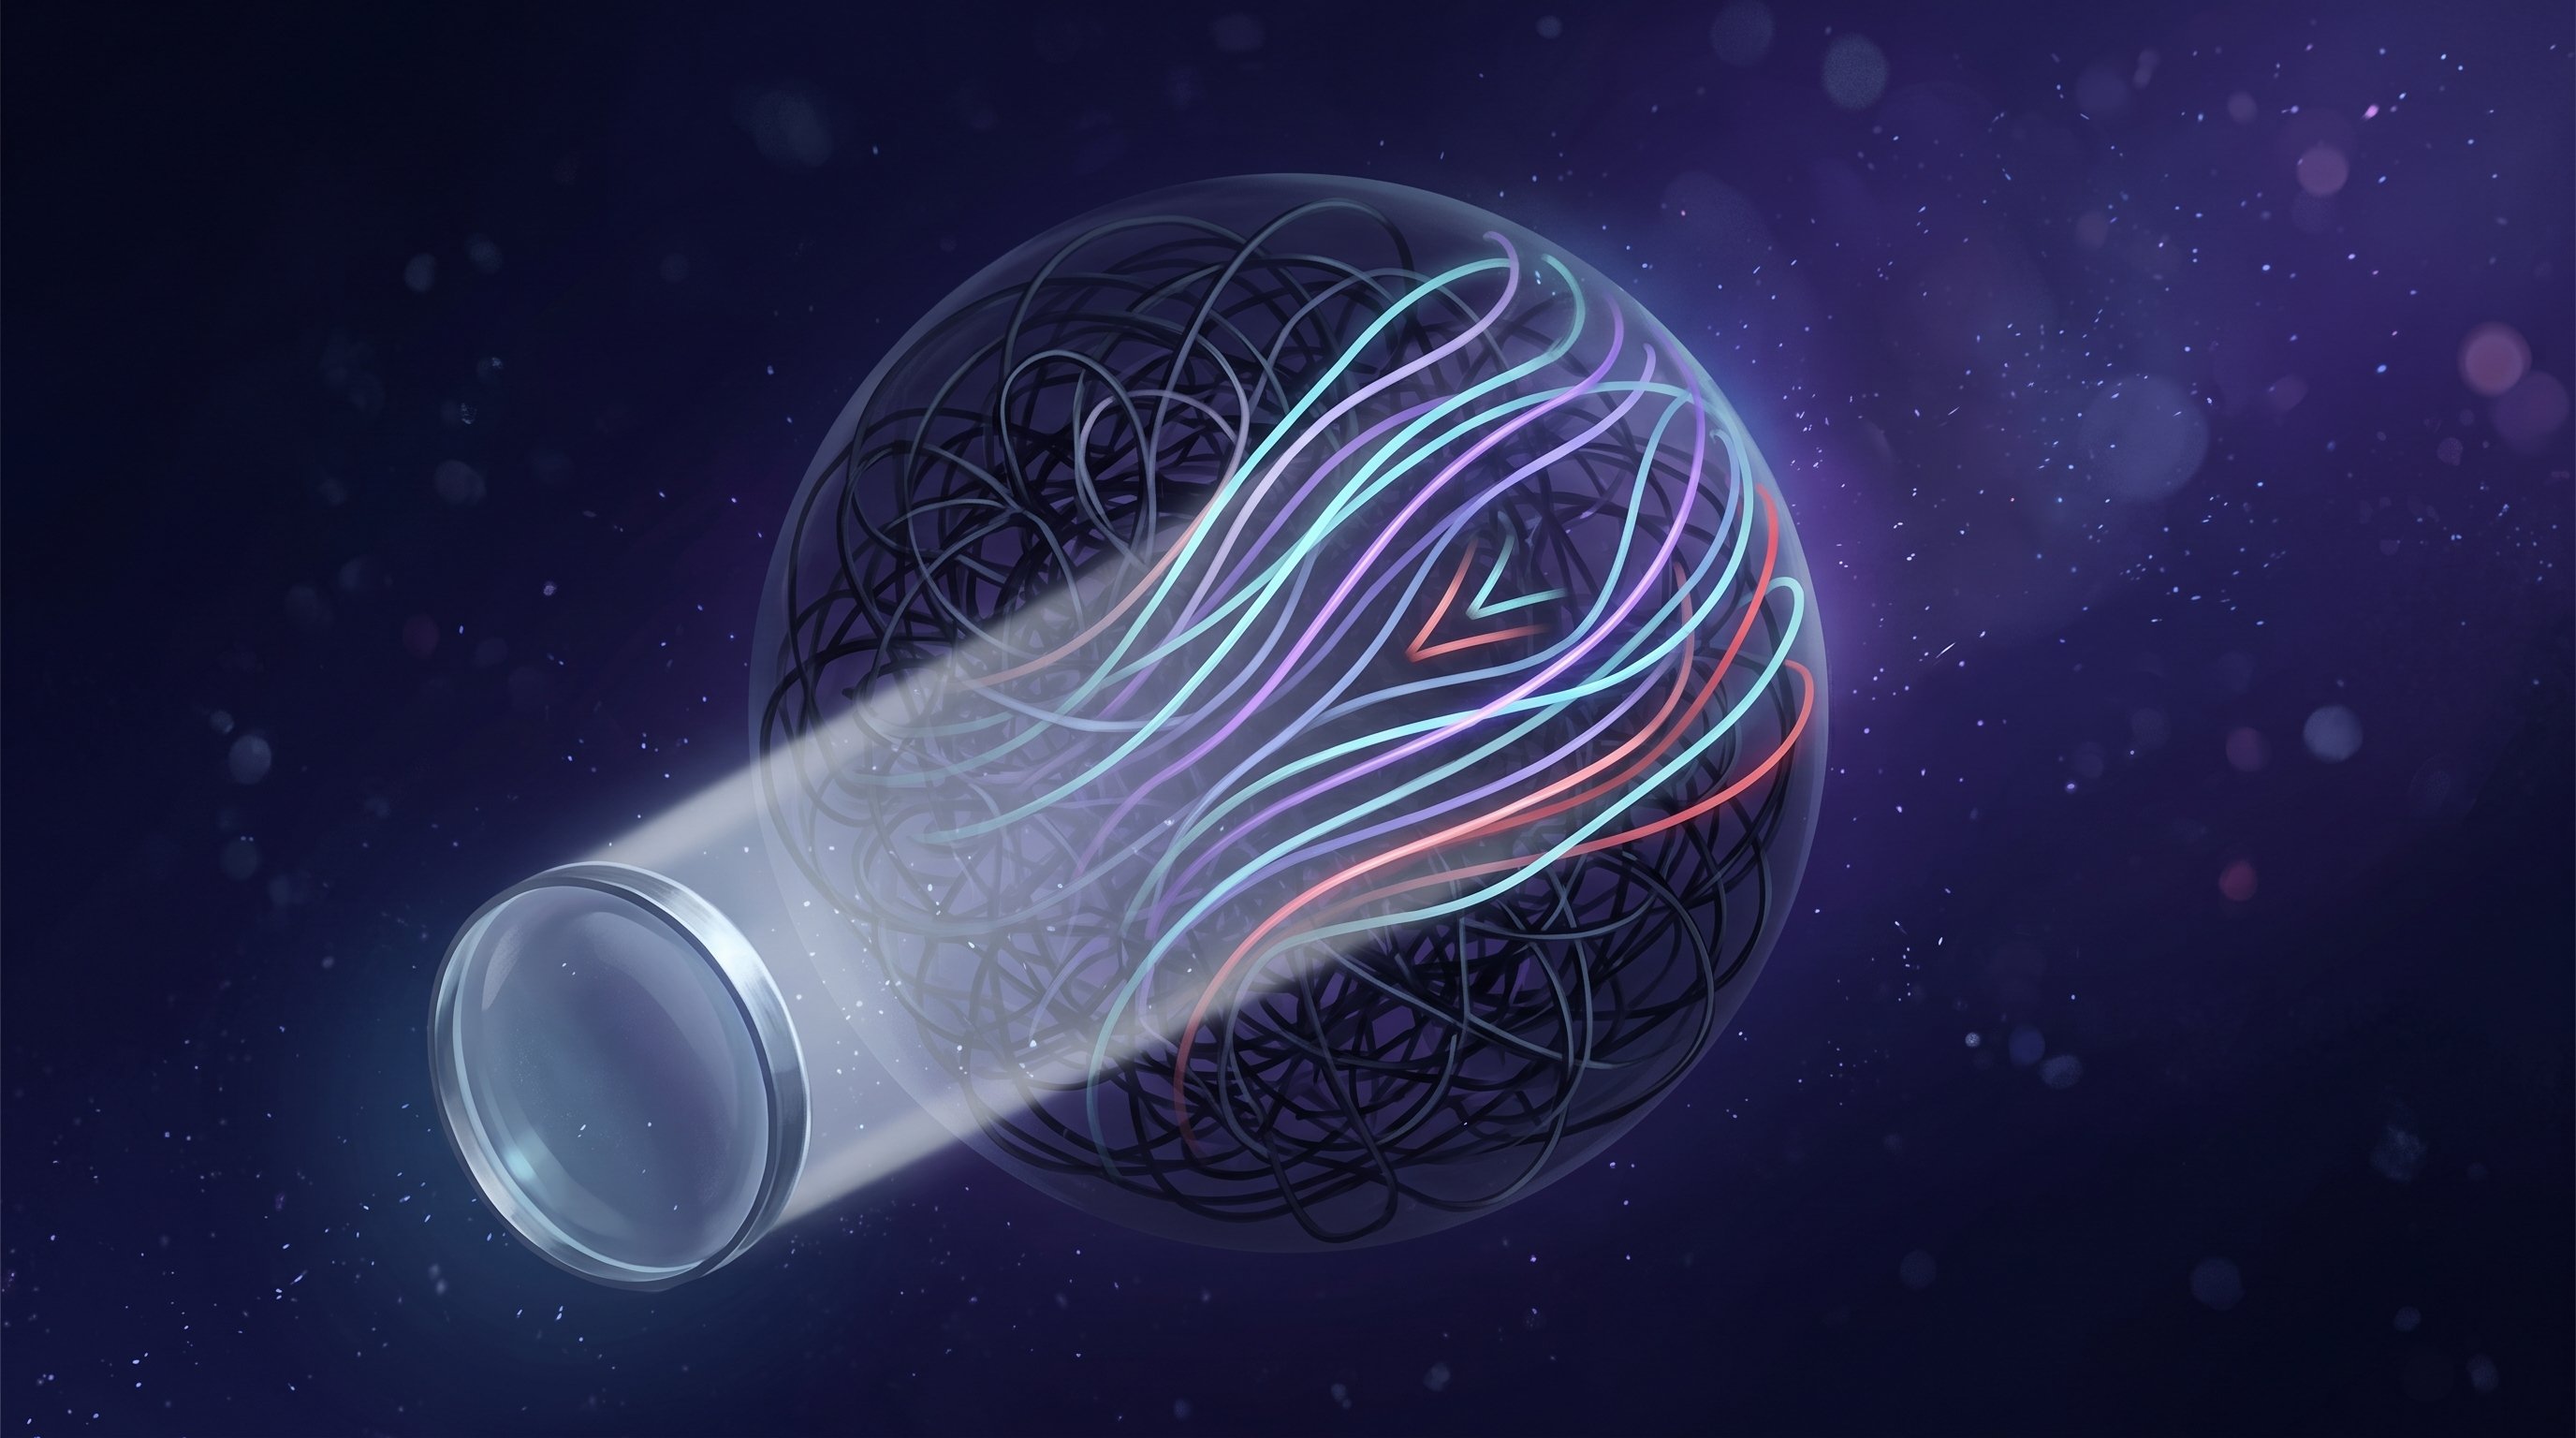
AI-modellen zoals ChatGPT en Claude worden vaak een 'zwarte doos' genoemd. Ze geven slimme antwoorden, maar niemand kan precies zien hoe ze daarop komen. Dat is lastig: wie niet begrijpt hoe een model denkt, kan ook moeilijk controleren of het veilig en eerlijk werkt.
Een essay van onderzoeker Nick Cammarata zorgt daarom voor veel discussie in de AI-wereld. Cammarata werkt bij het Amerikaanse bedrijf Goodfire en werkte eerder bij OpenAI. Half oktober 2026 publiceerde hij een lang stuk met de titel Neural Networks Are Already Clean: neurale netwerken zijn al overzichtelijk. MIT Technology Review sprak hem en andere experts.
Het oude idee: één neuron, veel taken
Een AI-model bestaat uit miljarden kleine rekeneenheden, die neuronen worden genoemd. Onderzoekers proberen al jaren uit te zoeken wat elk neuron doet. In 2020 vonden ze in een beeldherkenningsmodel van Google een neuron dat leek te reageren op zowel katten als auto's. Dat leek willekeurig.
De verklaring werd superpositie: een model zou veel meer begrippen kennen dan het neuronen heeft, en ze daarom door elkaar in dezelfde neuronen proppen. Als dat zo is, kun je een model niet begrijpen door neuronen één voor één te bekijken. Je moet het eerst ontwarren. Dat idee werd jarenlang breed aangenomen, ook door Cammarata zelf, die meehielp het te bedenken.
Het nieuwe idee: we keken verkeerd
Cammarata keek opnieuw naar hetzelfde neuron. Volgens hem reageert het helemaal niet op katten en auto's, maar op een V-vorm: een puntige kattensnuit, de voorkant van een auto, de neus van een snelle trein. Ronde vormen remmen het juist af. Het neuron heeft dus wel één duidelijke taak.
Hij zegt dat de verwarring vooral kwam door gewone, op te lossen problemen, zoals de manier waarop oudere modellen werden gebouwd en de beperkte gereedschappen van toen. Daarnaast ziet hij dat een neuron tijdens het leren soms uitgroeit van één begrip naar verwante begrippen. Dat lijkt op een warboel, maar is het volgens hem niet.
Cammarata zegt dat hij het afgelopen jaar bijna elke dag tien uur neuronen heeft bestudeerd, met hulp van teams van AI-agents die neuronen in kaart brengen en verklaringen testen. In een eerste, ruwe controle van het open taalmodel Qwen3 met 32 miljard rekenwaarden had volgens hem ongeveer 90 procent van de neuronen één hoofdtaak. Zo'n 7 procent had twee verwante taken, en 2 tot 4 procent begrijpt hij nog niet.
Enthousiasme en kritiek
Op sociale media reageerden sommige onderzoekers uitbundig. Anderen zijn voorzichtiger. Chris Potts van Stanford University noemt het stuk grondig, maar vooral een vermoeden dat nog streng getoetst moet worden. Jacob Hilton van het Alignment Research Center in Berkeley zegt dat we nog maar een heel klein deel van de grootste modellen begrijpen. Volgens hem moet je niet alleen losse neuronen begrijpen, maar ook hoe ze samenwerken. Neel Nanda van Google DeepMind vindt het werk interessant, maar ziet geen grote verschuiving in het totaalbeeld.
Cammarata erkent dat sommige mensen zijn woorden groter hebben gemaakt dan ze zijn. Hij noemt zijn vooruitblik zelf speculatief en zegt niet dat AI-modellen al volledig te begrijpen zijn. Wel denkt hij niet langer dat dat onmogelijk is. Een technisch artikel over neuronen in taalmodellen moet binnenkort volgen. Dan kunnen andere onderzoekers de resultaten controleren.
Wat betekent dit voor de weg naar de singulariteit?
Hoe krachtiger AI wordt, hoe belangrijker het is dat we kunnen zien wat er binnenin gebeurt. Dat is de basis voor veilige AI: een model dat je kunt doorlichten, kun je ook corrigeren. Als Cammarata gelijk heeft, is dat werk een stuk minder hopeloos dan veel onderzoekers dachten.
Opvallend is ook hoe hij werkt: met teams van AI-agents die zelf neuronen onderzoeken. AI helpt zo om AI te begrijpen. Cammarata schat dat één mens er honderdduizend jaar over zou doen om een topmodel stukje voor stukje te begrijpen, maar dat automatische onderzoekers dat flink kunnen versnellen. Dat is precies het soort samenwerking tussen mens en machine waar het de komende jaren om draait. De volgende stap is dat andere teams zijn resultaten nameten.