English
Taalmodel
Een taalmodel is een AI-model dat getraind is op enorme hoeveelheden tekst en daardoor tekst kan begrijpen, schrijven en vertalen. De chatbots die je kent, draaien op een taalmodel.
Een taalmodel is een AI-model dat heeft geleerd van enorme hoeveelheden tekst. Het kan daardoor vragen beantwoorden, teksten schrijven en samenvatten, vertalen en programmeercode maken. De bekende chatbots draaien op een taalmodel. Bij een groot taalmodel, in het Engels large language model of LLM, zijn zowel het model zelf als de hoeveelheid tekst waarmee het is getraind heel groot.
Hoe werkt het?
In de kern leert een taalmodel het volgende stukje tekst te voorspellen. Het leest een stuk tekst, gokt wat er hierna komt en kijkt hoe ver het ernaast zat. Dit gebeurt miljarden keren. Zo pikt het patronen op in taal, maar ook in de kennis die in die teksten staat. De tekst wordt daarbij in kleine stukjes gehakt, de tokens, en het model werkt met die stukjes.
Wat het model heeft geleerd, zit in zijn parameters: miljarden getallen. Een antwoord ontstaat meestal stukje voor stukje, waarbij elk nieuw stukje afhangt van wat er al staat. Er bestaan ook modellen die het anders doen. Mercury 3 van het Amerikaanse Inception maakt eerst een ruwe versie van de hele tekst en scherpt die in een paar rondes aan. Volgens het bedrijf is het model daardoor vier tot acht keer zo snel als vergelijkbare modellen (link).
Waarom het ertoe doet
Taalmodellen zijn de motor achter bijna alle AI-nieuws. Ze vormen de basis van AI-agents die zelfstandig taken uitvoeren. Ze worden ook ingezet in de wetenschap, bijvoorbeeld om eiwitten te ontwerpen of experimenten te bedenken.
Het trainen van zo'n model kost veel rekenkracht, en daar wordt hard aan gewerkt. Microsoft AI rondde de eerste trainingsfase van zijn basismodel MAI-Base-2 af. Volgens het bedrijf haalt het model hetzelfde niveau als een sterk Chinees model, met 4 tot 12 keer minder rekenwerk (link). Hoe goed een taalmodel is, meten onderzoekers met vaste toetsen, de benchmarks.
Artikelen over Taalmodel
-
Muse en Meta AI krijgen nieuwe modellen die beter onthouden en doorzetten
Meta rolt nieuwe modellen uit in zijn AI-assistent Muse en in Meta AI, getraind met behulp van zijn krachtigste model Muse Wonder. Volgens het bedrijf vergeten ze belangrijke informatie 2,4 keer minder vaak en maken ze taken beter af als er iets misgaat.
-
Nieuw AI-geheugen vat een hele stapel documenten per vraag samen in 16 tokens
Onderzoekers van onder meer Stanford maakten Memorilla: een geheugen dat per vraag een hele documentenverzameling samenvat in 16 tokens. In hun eigen proeven scoort een taalmodel daarmee meestal beter dan met alle tekst erbij, en het antwoordt veel sneller. Exacte namen raken soms verloren.
-
Baidu geeft groot AI-model ERNIE 5.5 Flash Base vrij, maar niet voor Europa
Het Chinese techbedrijf Baidu heeft een groot AI-model vrijgegeven dat ontwikkelaars zelf verder kunnen trainen. Het model is snel en zuinig gebouwd en scoort volgens Baidu goed in tests. De licentie geldt alleen niet in de EU, het Verenigd Koninkrijk en Zuid-Korea.
-
Unsloth maakt groot open AI-model van Alibaba kleiner en volgens eigen tests nauwkeuriger dan anderen
Unsloth heeft nieuwe, kleinere versies uitgebracht van Qwen3.8-Flash-Next, een groot open AI-model van Alibaba. Volgens eigen tests maken ze gemiddeld 15 procent betere scores dan andere ingekrompen versies. Zo kunnen meer mensen het model op hun eigen computer draaien.
-
Tencent brengt Hy4 uit: open AI-model dat beelden begrijpt en een computer bedient
Het Chinese Tencent heeft Hy4 uitgebracht, een groot taalmodel dat voor het eerst afbeeldingen begrijpt en zelf een computer kan bedienen. Volgens Tencent verzint het veel minder dan de vorige versie. De modelbestanden komen de komende dagen vrij beschikbaar.
-
Open AI-model voorspelt hoe RNA zich vouwt, getraind op 21 miljoen voorbeelden
Onderzoekers uit China presenteren in Nature structRFM, een AI-model dat leert hoe RNA-moleculen zich vouwen. In tests doet het volgens de makers mee met AlphaFold3 van Google DeepMind. Data, model en code zijn vrij beschikbaar.
-
Klein open AI-model van Xpeng ziet beter waar dingen staan dan GPT-6 Astra
Autobouwer Xpeng en universiteiten hebben GroundingPI uitgebracht, een open AI-model dat robots en auto's helpt precies te zien waar dingen staan. Op 34 tests scoort het volgens de makers gemiddeld iets hoger dan OpenAI's veel grotere GPT-6 Astra.
-
AI maakt hacken makkelijker, maar helpt ook de verdedigers
Slimme AI-agents die zelf code lezen en schrijven, maken hacken makkelijker, vooral open modellen waarvan de remmen er zo af zijn. Maar dezelfde AI vindt ook lekken voordat aanvallers dat doen. Een kat-en-muisspel, met recente voorbeelden in Nederland.
-
Google DeepMind geeft AI-agent vaardigheden voor scheikunde: werk aan nieuwe medicijnen van dagen naar een uur
Google DeepMind heeft vaardigheden voor scheikunde uitgebracht voor zijn AI-platform Antigravity. In een demonstratie deed een AI-agent daarmee in ongeveer een uur werk aan nieuwe medicijnen waar scheikundigen volgens Google meestal dagen over doen. De ontwerpen moeten nog in het lab worden getest.
-
Chinees bedrijf geeft AI-model voor scheikunde vrij, getraind op eigen labwerk
Het Chinese Deep Principle heeft Hydrogen-1.0 vrijgegeven, een AI-model voor scheikunde en materiaalonderzoek dat iedereen mag downloaden. Het leerde ook van mislukte proeven uit het eigen lab. De prestaties zijn nog door het bedrijf zelf gemeten.
-
Tencent laat AI zelf gereedschap bouwen voor eiwitonderzoek en wiskunde
Tencent heeft de tweede versie van zijn onderzoeks-AI Hyra gepresenteerd. Die levert niet alleen oplossingen, maar ook gereedschap dat later weer bruikbaar is. Modellen voor eiwitten en moleculen staan al openbaar, zodat andere onderzoekers ze nu zelf kunnen testen.
-
Nieuwste AI-model kan de binnenkant van andere AI lezen en zelf schrijven
Onderzoekers van MIT lieten GPT-6 Astra van OpenAI de getallen lezen en aanpassen waaruit kleine AI-netwerken bestaan, zonder training. Zo schreef het zelf netwerken die een computerspel goed spelen. De onderzoekers noemen het nog heel vroege resultaten.
-
Meituan brengt LongCat-2.5 uit: multimodaal agentenmodel van 1,6 biljoen parameters, getraind op Chinese chips
Het Chinese bedrijf Meituan bracht op 2 november LongCat-2.5 uit, een groot AI-model dat tekst en beeld verwerkt en lange programmeertaken zelfstandig kan uitvoeren. Volgens Meituan is het volledig getraind op Chinese chips en haalt het in tests bijna het niveau van Claude Opus 5.
-
Diagnostische AI AMIE voor het eerst getest met echte patiënten in huisartspraktijk
Googles medische AI AMIE voerde in een Amerikaanse huisartspraktijk gesprekken met 100 echte patiënten, vóór hun afspraak bij de dokter. Geen enkel gesprek hoefde om veiligheidsredenen te stoppen. De studie staat in The Lancet; grotere proeven zijn de volgende stap.
-
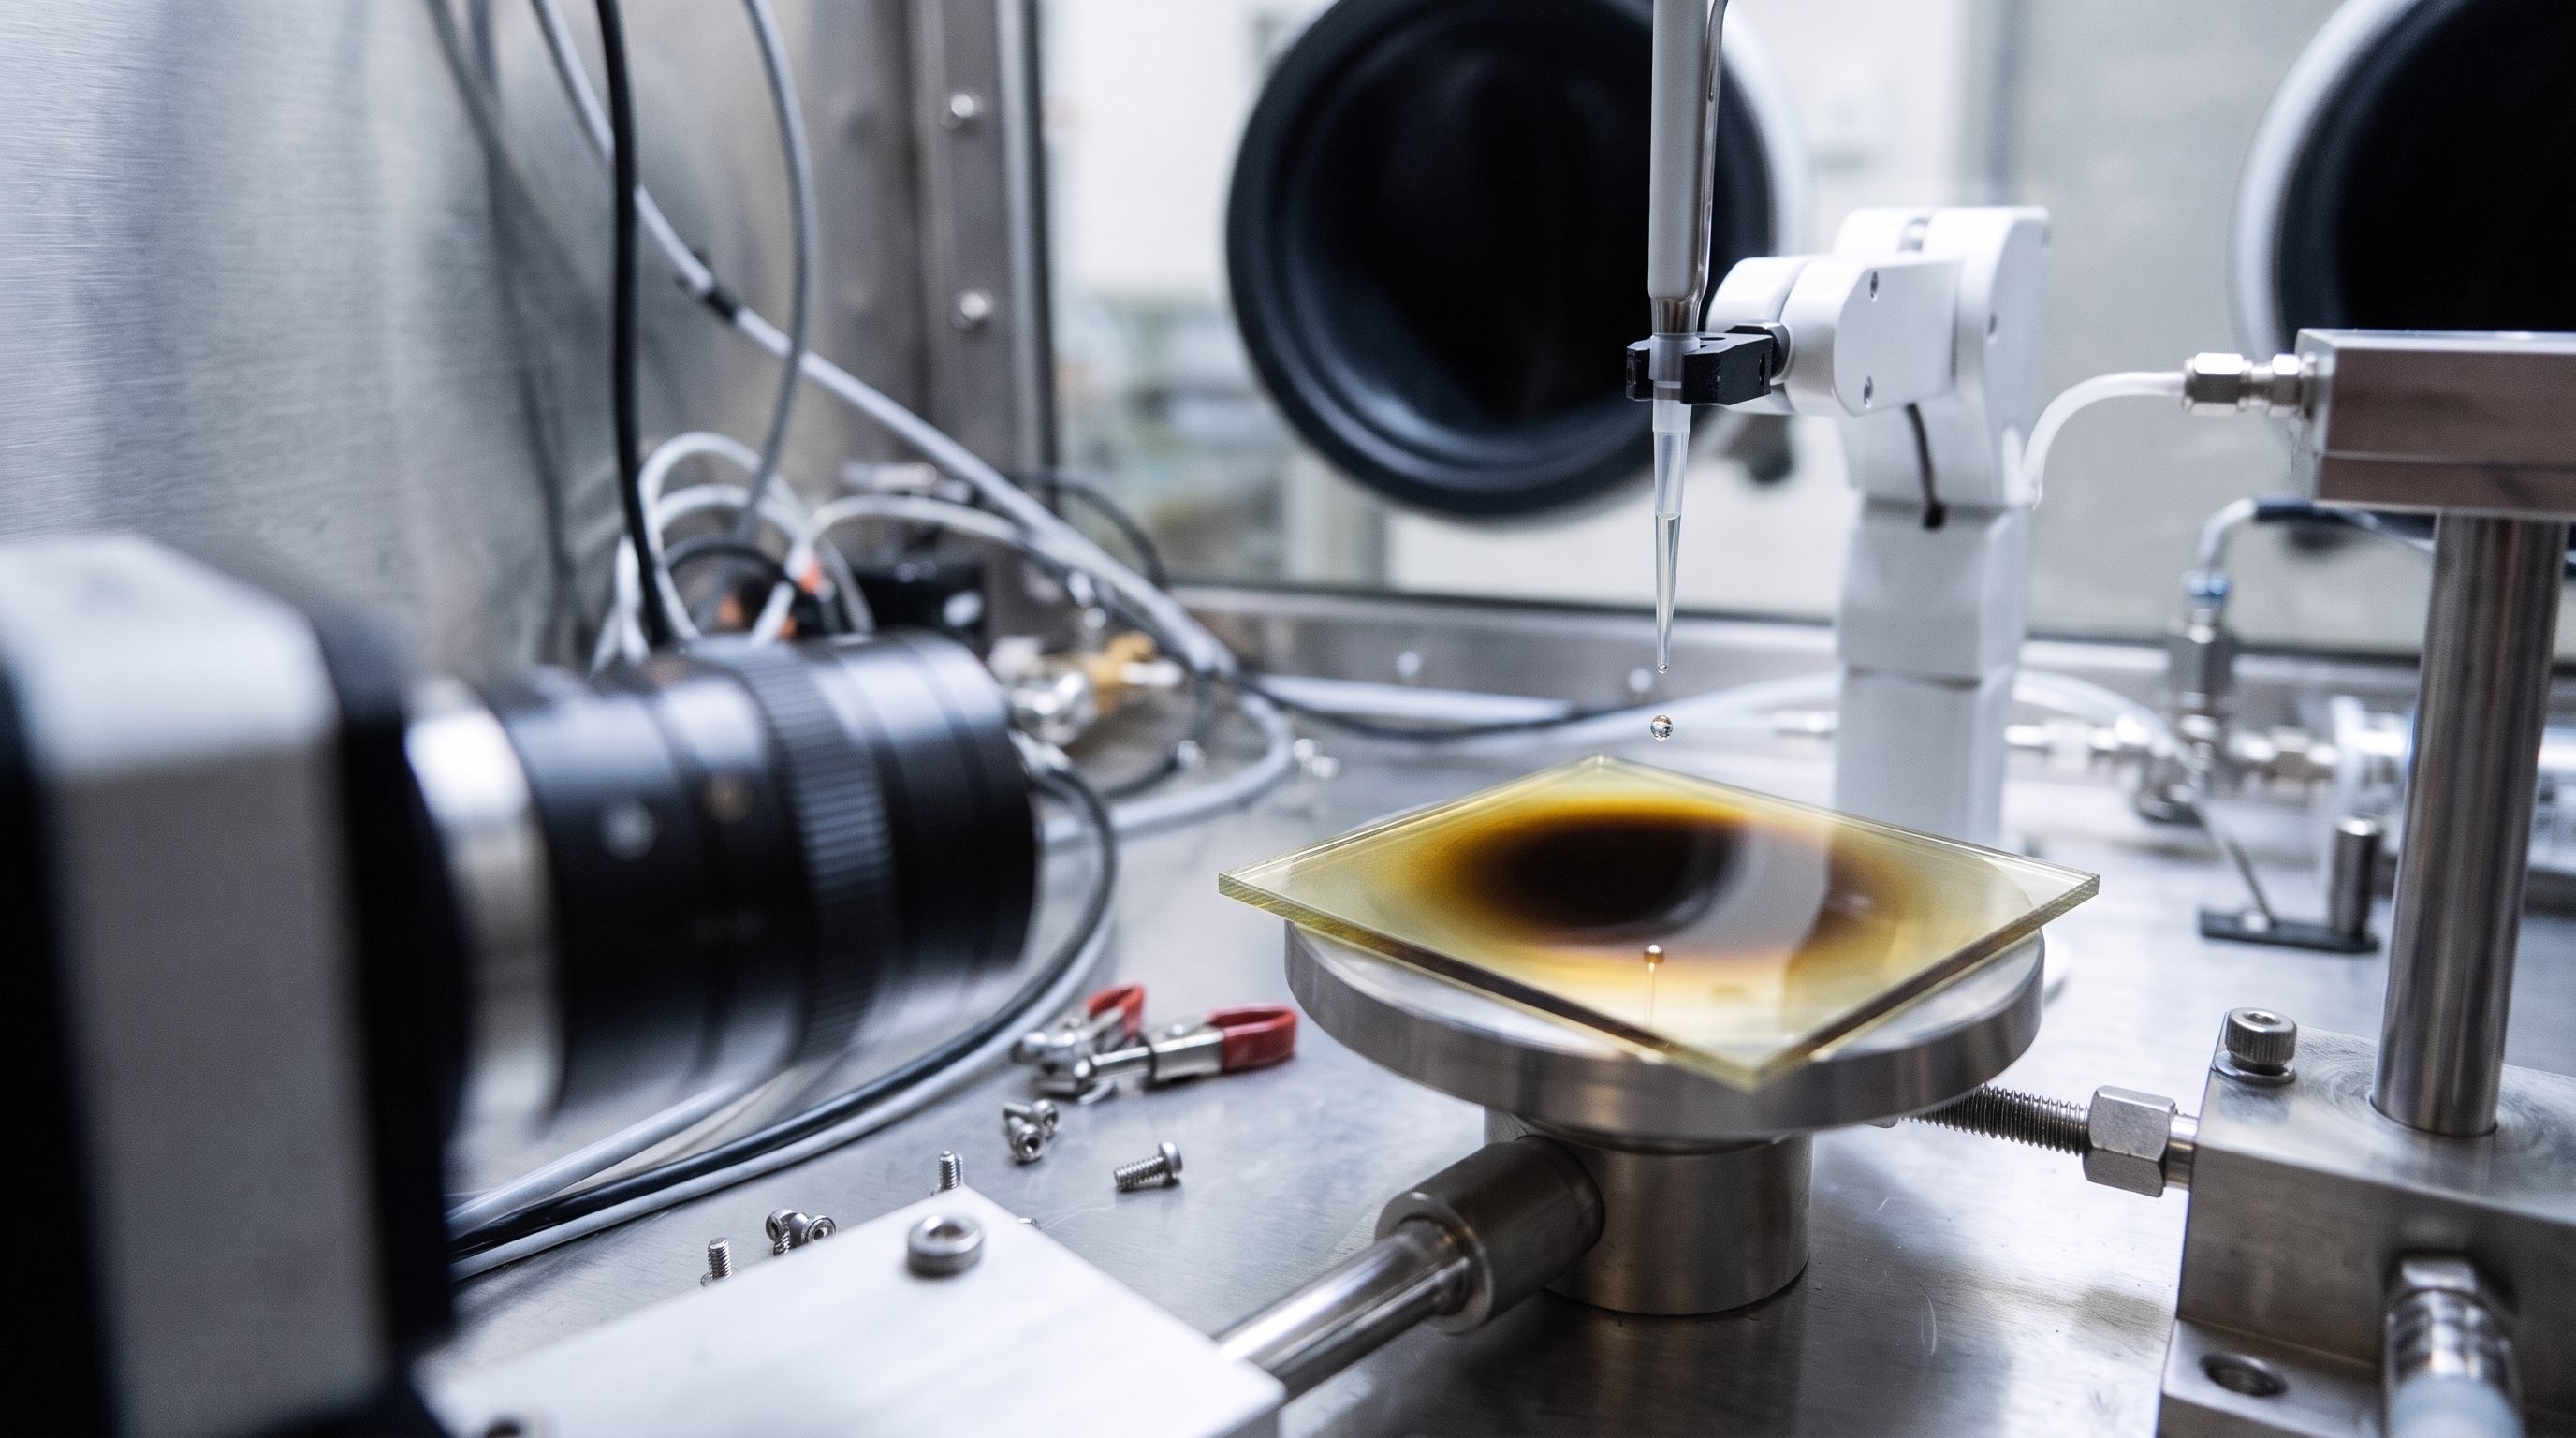
Robot met supersnelle camera vindt betere manier om perovskiet-zonnecellen te maken
Onderzoekers van de Universiteit van Osaka bouwden een robotplatform dat in milliseconden filmt hoe de laag van een perovskiet-zonnecel ontstaat. Met machine learning vonden ze een betere werkwijze; hun cel zet 24,4 procent van het zonlicht om in stroom.