Verzonnen bedrijfsdata met een bekend antwoord leren AI-agents beter analyseren
Onderzoekers van Meituan en Chinese universiteiten bouwen nepwerelden vol rommelige bestanden, waarvan ze precies weten wat erachter zit. Zo kun je controleren of een AI-agent echt de goede conclusie trekt. Een model dat ermee oefende, werd duidelijk beter in data-analyse.
Steeds meer bedrijven laten AI-agents hun gegevens analyseren. Zo'n agent is een AI die zelf aan het werk gaat: hij opent spreadsheets en andere bestanden, schrijft kleine programma's om ermee te rekenen en trekt daar conclusies uit. Bijvoorbeeld: waarom komen bestellingen de laatste tijd vaker te laat?
Om zo'n agent goed te trainen, heb je veel oefenmateriaal nodig. Echte bedrijfsdata is daarvoor lastig. Het is duur om te verzamelen, vaak vertrouwelijk, en bij een open vraag weet niemand zeker wat het juiste antwoord is. Dan kun je ook niet controleren of de AI het goed doet, of alleen iets zegt wat aannemelijk klinkt.
Onderzoekers van het Chinese techbedrijf Meituan en verschillende Chinese universiteiten hebben daar een oplossing voor bedacht. Hun systeem heet Data World. Ze publiceerden het werk op 15 oktober 2026 op arXiv, een website waar onderzoekers hun artikelen delen voordat vakgenoten ze hebben beoordeeld.
Eerst de wereld, dan de bestanden
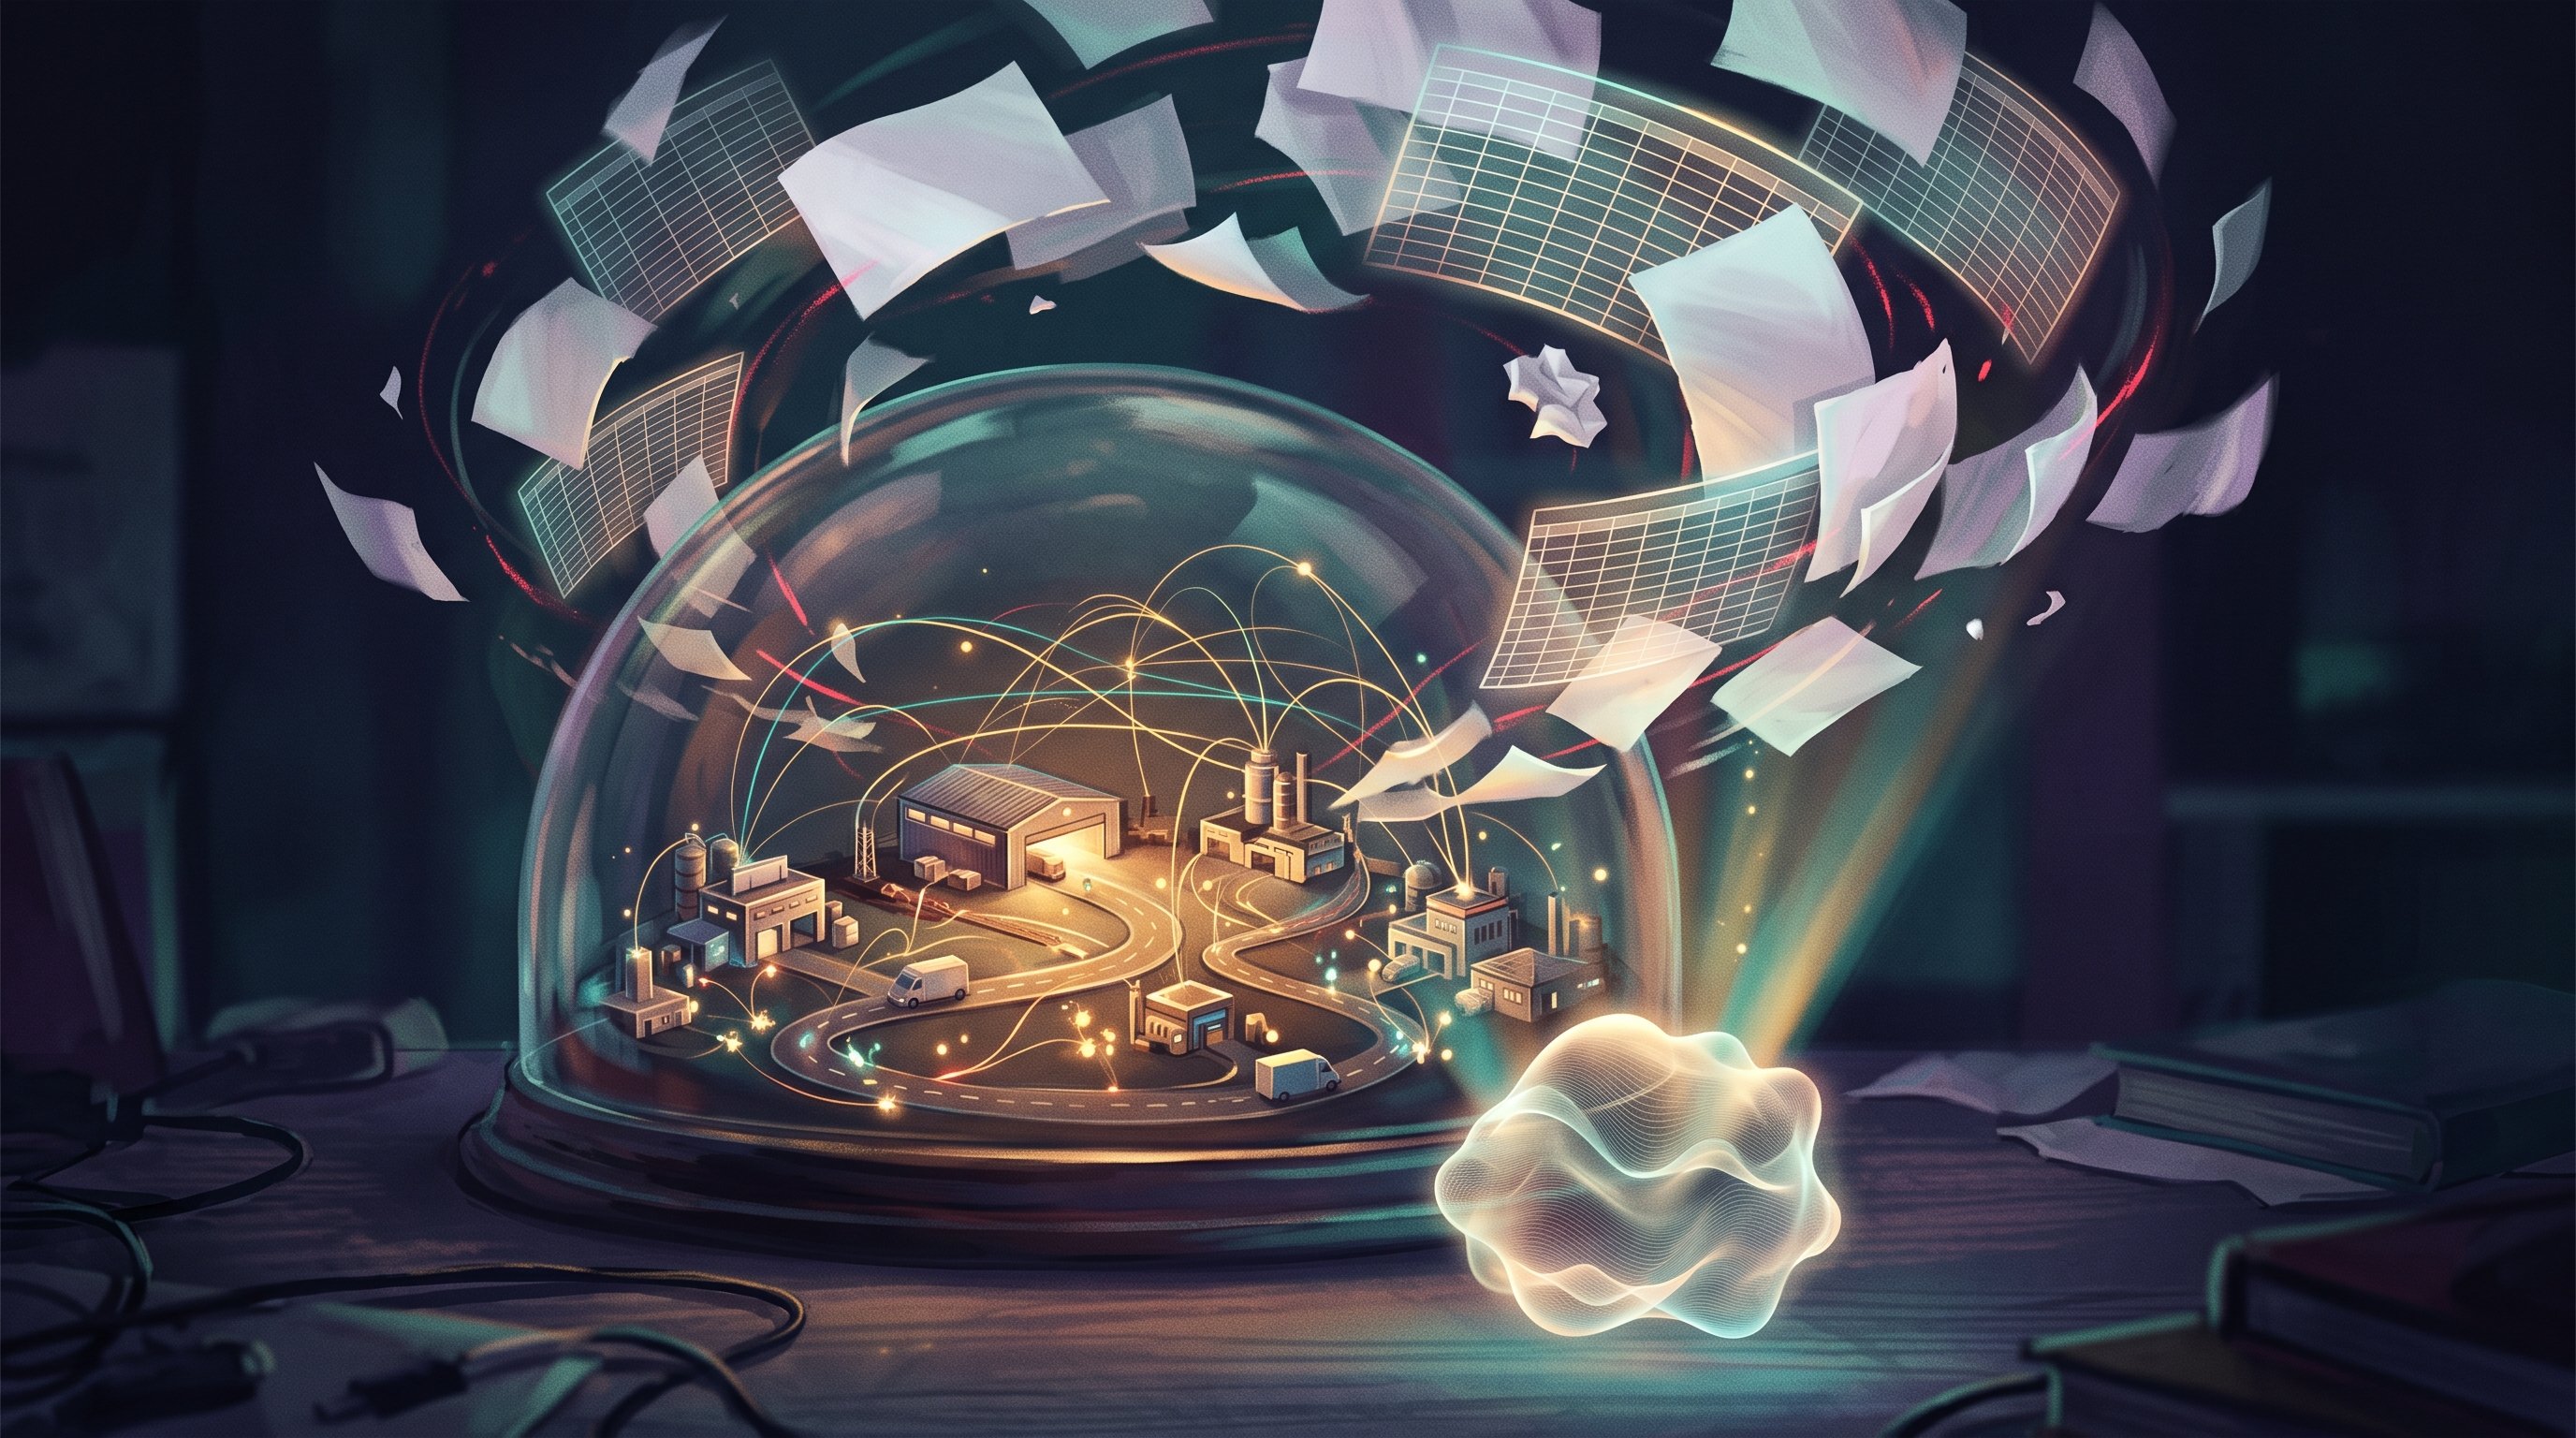
Het idee is om het omgekeerd te doen. Data World verzint eerst de regels van een kleine wereld, bijvoorbeeld hoe leveranciers, een magazijnvoorraad en bezorgingen op elkaar inwerken. Pas daarna maakt het de bestanden die zo'n bedrijf zou hebben: bestellijsten, voorraadoverzichten en logboeken.
Die bestanden zijn expres rommelig, net als in het echt. Er ontbreken waarden, er staan dubbele regels in, gegevens komen te laat binnen en nummers sluiten niet altijd op elkaar aan. Een aparte controle kijkt daarna of het juiste antwoord toch nog uit de bestanden te halen is.
Vergelijk het met een docent die een puzzel maakt. Omdat de docent zelf de oplossing heeft bedacht, kan die precies nakijken of een leerling hem goed heeft opgelost. Zo kan Data World ook vragen en een nakijkmodel maken die passen bij wat er echt in de nepwereld gebeurt.
Rekenen gaat goed, verklaren is lastiger
Met het systeem maakten de onderzoekers een toets van 100 opdrachten in 50 verschillende werelden, verspreid over 16 vakgebieden. Daarop testten ze tien van de beste AI-modellen van dit moment. Het beste model, GPT-6-Astra van OpenAI, haalde gemiddeld ongeveer 74 van de 100 punten.
Opvallend: alle modellen waren beter in rekenen met de gegevens dan in het vinden van de verklaring erachter. Een AI kan dus vaak keurig uitrekenen dát er meer bestellingen te laat zijn, maar heeft meer moeite met de vraag waaróm. Juist die vraag is voor een bedrijf het interessantst.
Oefenen helpt
De onderzoekers maakten ook ruim 2.100 oefenopdrachten in ruim 1.000 andere werelden. Daarmee trainden ze een open taalmodel van het Chinese bedrijf Alibaba, door het te laten oefenen en te belonen voor goede antwoorden. Het model kreeg dus geen voorbeeldoplossingen van sterkere modellen.
Volgens de onderzoekers ging het getrainde model op hun eigen toets van ongeveer 38 naar 45 van de 100 punten. Daarmee komt het dichter bij GPT-6-Astra. Ook op drie andere, bestaande toetsen voor data-analyse en werkopdrachten, die eveneens tot 100 punten lopen, ging het er 12 tot 21 punten op vooruit. Op een van die toetsen steeg de score bijvoorbeeld van ongeveer 26 naar 47 punten. Wat het in de nepwerelden leerde, helpt dus ook bij andere opdrachten.
Het gaat de onderzoekers vooral om de oefenmethode, niet om het inhalen van de grootste modellen. Het getrainde model is wel open: iedereen kan het downloaden. Bedrijven kunnen zo'n model op hun eigen computers draaien, zodat vertrouwelijke gegevens binnen blijven.
Het zijn de eerste resultaten, gemeten door de onderzoekers zelf. De volgende stap is laten zien hoe goed het werkt met echte bedrijfsgegevens. De code staat openbaar op GitHub, zodat anderen de methode zelf kunnen gebruiken en testen.
Wat betekent dit voor de weg naar de singulariteit?
Een AI wordt pas echt nuttig als je erop kunt vertrouwen dat zijn conclusies kloppen. Dat geldt voor bedrijfscijfers, maar ook voor wetenschap, waar AI-agents al helpen bij bijvoorbeeld het zoeken naar nieuwe antibiotica. Data World laat zien hoe je dat vertrouwen kunt opbouwen: oefenen in een wereld waarvan je het antwoord kent, en pas daarna los op de echte wereld.
Dat het oefenmateriaal door de computer zelf wordt gemaakt, is daarbij een belangrijke stap. Het tekort aan goede, controleerbare trainingsdata is een van de grenzen van AI. Kan AI zelf eindeloos nieuwe oefenwerelden bouwen, dan kunnen agents blijven leren zonder te wachten op echte data. Zo groeien ze stap voor stap van handige rekenhulp naar een collega die ook de verklaring achter de cijfers vindt.