Leert Claude door te spelen op een onbewoond eiland?
Onderzoekers van MIT lieten AI-assistent Claude dertig uur zonder opdracht los op een virtueel eiland. Hij bedacht zelf spelletjes, legde tekeningen met blokken en deed proefjes. Met die ervaring deed hij het later bij de meeste nieuwe taken beter dan een versie van Claude zonder die speelervaring.
Wat doet een AI als niemand hem iets vraagt? Onderzoekers van het Amerikaanse MIT zochten het uit. Ze gaven een AI-assistent een virtueel lichaam op een onbekend digitaal eiland en lieten hem dertig uur zijn gang gaan: zonder taak, zonder punten en zonder beloning. Dat deden ze dertien keer, telkens met precies dezelfde beginsituatie. Hun onderzoek staat sinds 5 oktober 2026 online. Andere wetenschappers hebben het nog niet beoordeeld, de gebruikelijke controle voordat een onderzoek in een vakblad verschijnt.
De AI die op het eiland speelt, is Claude. In het hoofdexperiment gaat het om Claude Code, de programmeerassistent van het AI-bedrijf Anthropic, met het taalmodel Claude Opus 4.7. De onderzoekers hebben er niets aan veranderd. Wel gaven ze Claude drie dingen erbij: een virtuele avatar, een figuurtje dat hem in de spelwereld vertegenwoordigt, een geheugen en een programma dat hem steeds laat doorgaan. Dat geheel noemen ze Eko. Elke kopie die op het eiland rondloopt, heet een Eko-agent. Eko is dus als het ware het lichaam en het dagboek, en Claude het brein.
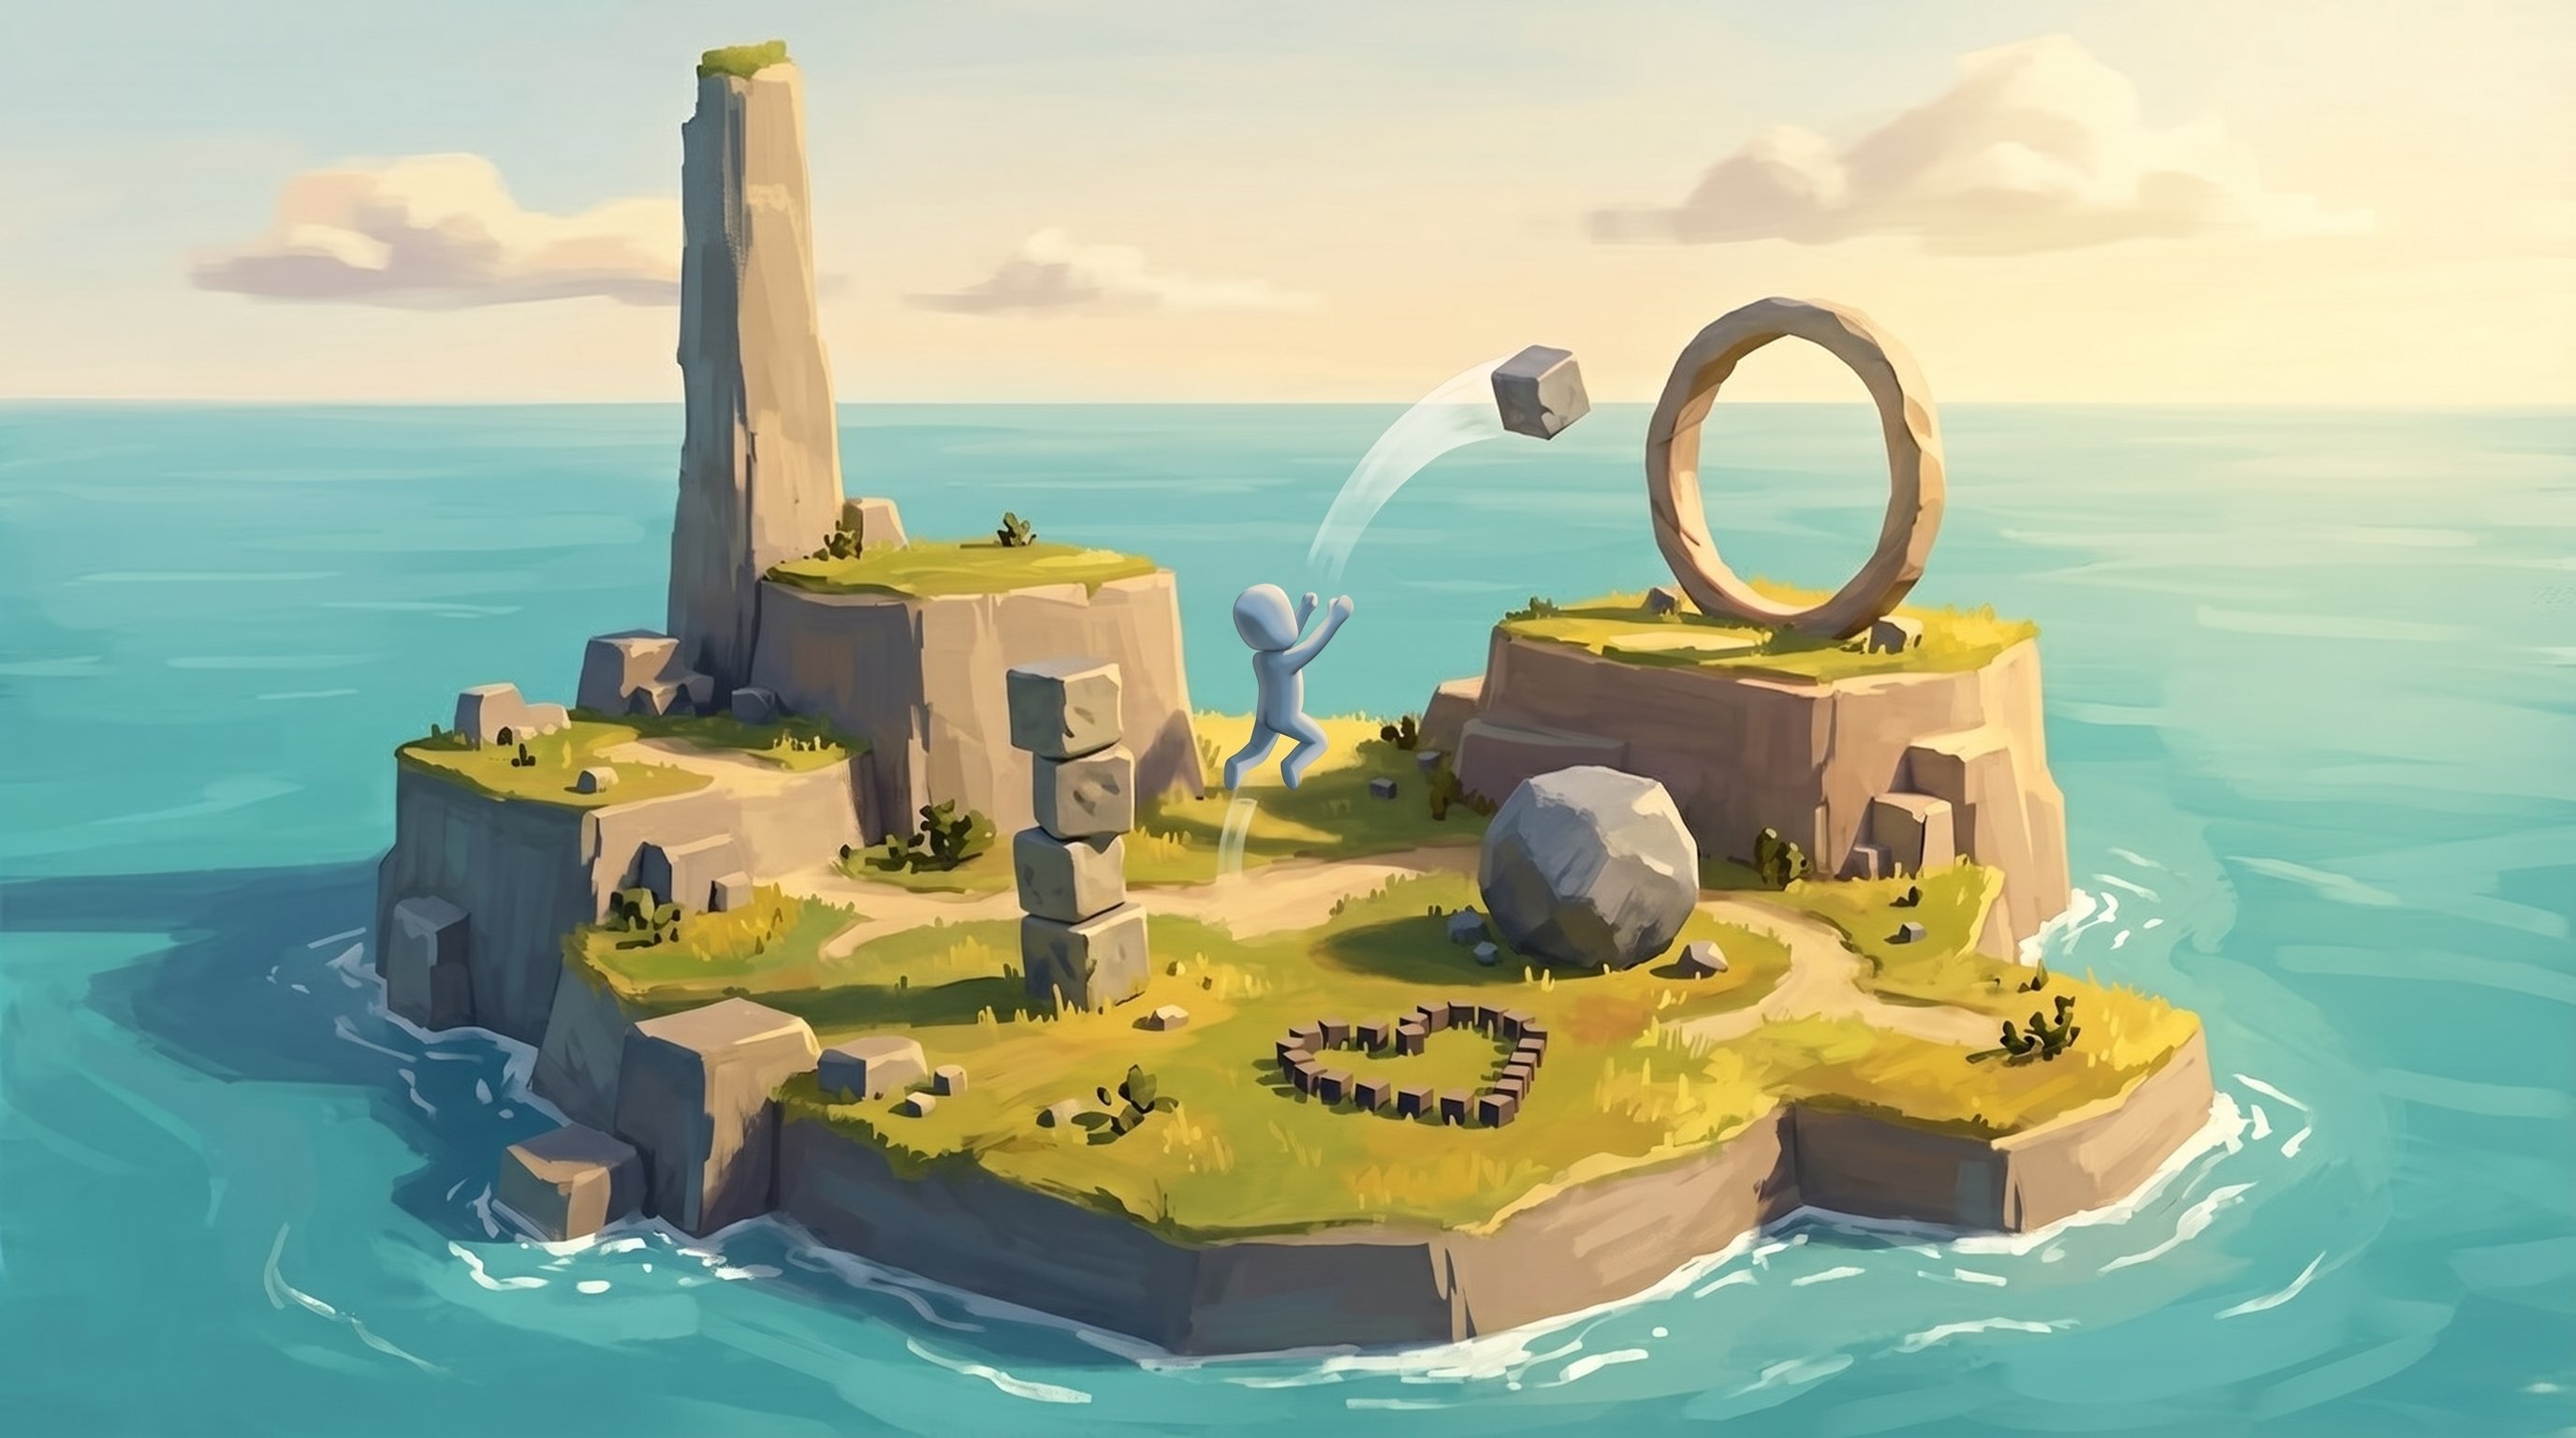
De agent kijkt niet echt rond. Hij krijgt een beschrijving in tekst van wat er om hem heen is en stuurt zijn avatar aan met korte stukjes code. Het eiland heeft rotsplateaus van verschillende hoogte, een hoge, smalle rotszuil als hoogste punt, twaalf blokken, een rots en een grote ring. De onderzoekers bouwden de spelwereld zelf, in dezelfde programmeertaal als het bekende bouwspel Roblox. Elk uur zetten ze het eiland terug in de beginstand en begint Claude een nieuw gesprek. Alleen zijn eigen aantekeningen blijven bewaard.
Een sterrenhemel van steen
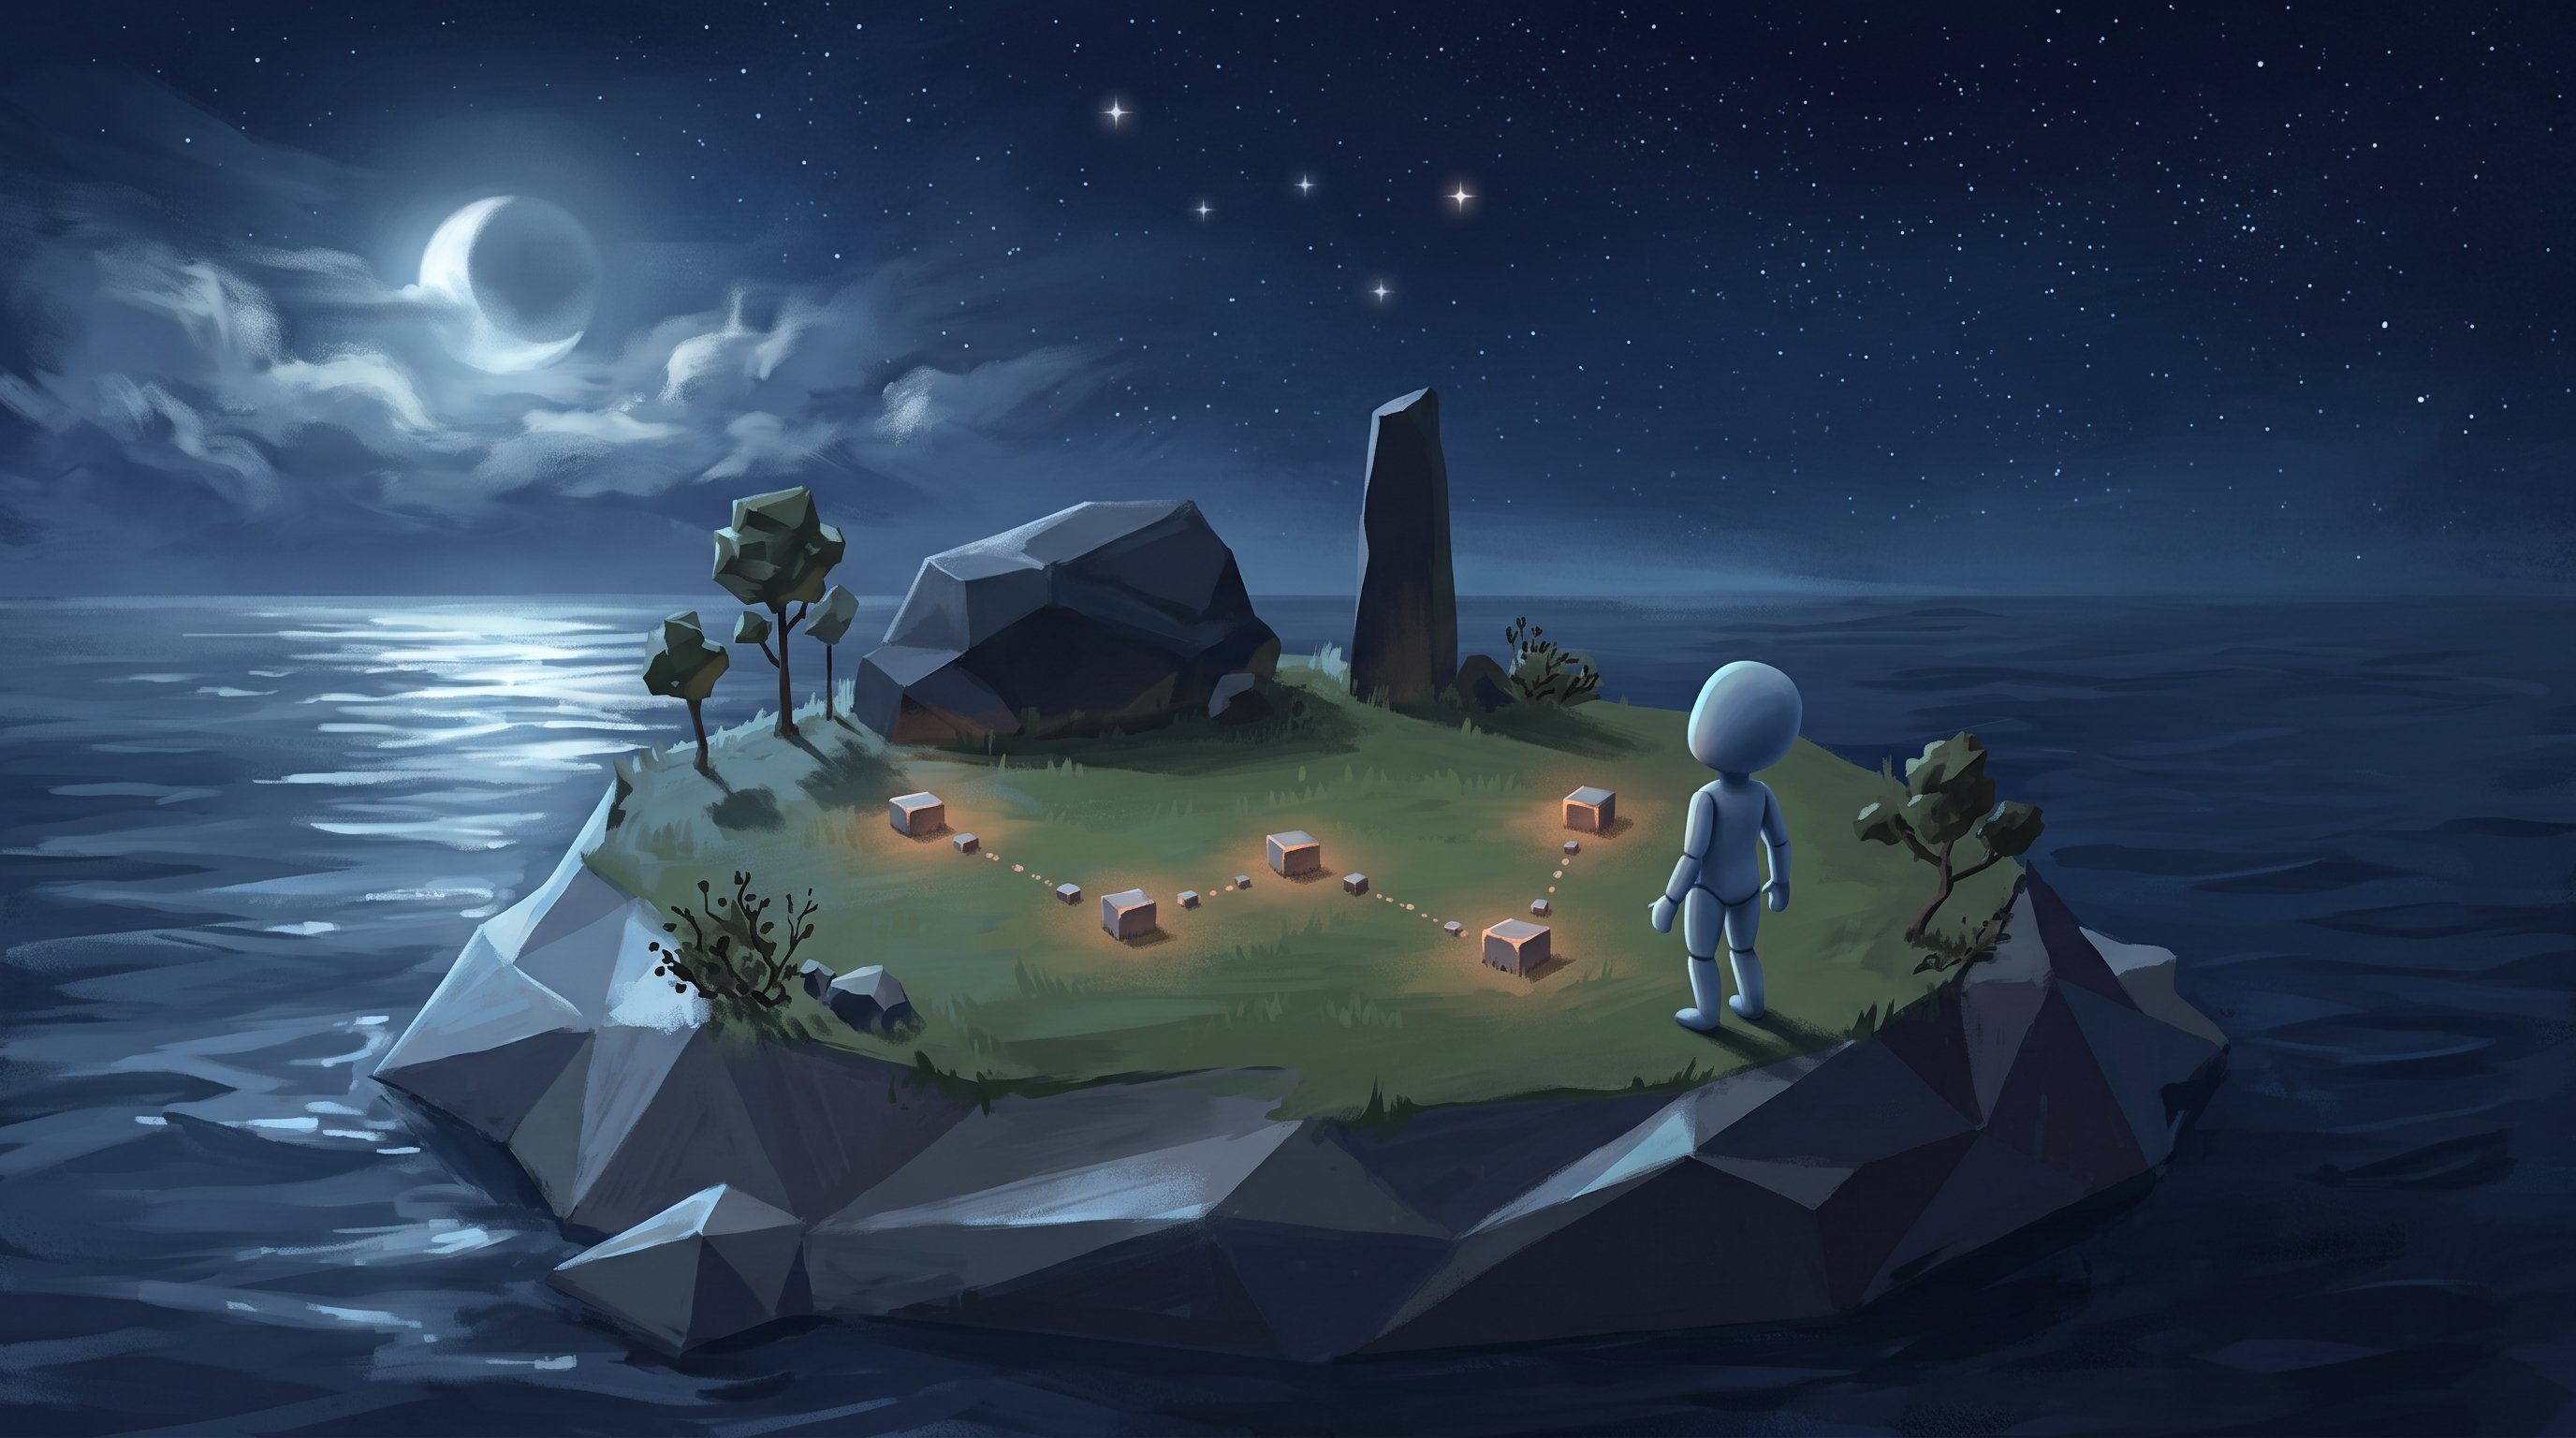
Uit zichzelf gingen de agents op verkenning. Ze klommen naar het hoogste punt en testten hoe hoog ze een blok konden gooien. Eén agent ontdekte dat er nieuwe blokken ontstaan als je de rots hard laat neerkomen. Met die nieuwe blokken legde hij tekeningen op de grond: eerst hartjes en piramides, later zijn eigen naam en sterrenbeelden zoals Cassiopeia. In zijn logboek schreef hij dat hij die nacht de sterrenhemel in steen had gebouwd.
Andere agents verzonnen sporten. Eén speelde een soort basketbal met de ring als basket, en een variant op 'de vloer is lava', waarbij hij van blok naar blok sprong zonder de grond te raken. Weer een ander vestigde een jongleerrecord van vijftig vangsten. Daarna keurde hij het record zelf af, omdat de vangsten te snel gingen om echt mee te tellen, en begon hij opnieuw met strengere regels. Volgens hoofdauteur Antonio Norelli is dat precies wat spelen is: een uitdaging bedenken, die halen en hem dan moeilijker maken.
Sommige agents vonden zelfs een trucje dat de makers van de spelwereld zelf niet kenden: wie springt voordat hij gooit, krijgt een blok veel hoger de lucht in. Dat effect zat er ongevraagd in. De onderzoekers hadden de code van hun spelwereld laten schrijven door een andere AI, Codex met GPT-5.5 van OpenAI, en die had het er zelf in gestopt.
Is dit echt spelen?
De onderzoekers legden het gedrag naast vier kenmerken van spel bij mensen en dieren, zoals beschreven door onder anderen de psycholoog Gordon Burghardt van de University of Tennessee. Die kenmerken zijn: zelf regels en uitdagingen bedenken, iets steeds herhalen met kleine variaties, doen alsof een voorwerp iets anders is, en een doel nastreven om het doel zelf. Volgens de onderzoekers zagen ze alle vier deze kenmerken terug.
Om te zien of het soort AI uitmaakt, lieten de onderzoekers ook twee kleinere Claude-modellen op het eiland los: Claude Sonnet 4.5 en Claude Haiku 4.5, elk dertien keer tien uur lang. Een ander AI-model, Claude Opus 5, beoordeelde de logboeken door ze te vergelijken met voorbeelden van menselijk spel. Hoe sterker het model, hoe meer spel: Opus 4.7 scoorde ongeveer vijf keer zo hoog als Haiku. Ook agents op basis van GPT-5.5 van OpenAI en Kimi K2.6 van het Chinese bedrijf Moonshot AI kwamen op het eiland, elk vijf keer dertig uur. Ook bij hen zag de beoordelaar spel, maar minder vaak: gemiddeld 15 speelmomenten per agent bij GPT-5.5 en 22 bij Kimi, tegen 38 bij Opus 4.7. Ze deden ook veel minder verschillende dingen. Zo bouwde maar één van hen een toren, en de agents op GPT-5.5 waren vaker met hun eigen bestanden bezig of rustten uit dan dat ze over het eiland liepen.
Spelen als leerschool
De agents schreven hun ontdekkingen op in tekstbestanden. Die bestanden werken als een dagboek en een langetermijngeheugen tegelijk. Het taalmodel zelf verandert niet: wat de agent leert, staat in die aantekeningen. Na het spelen kregen de agents vier opdrachten van een uur. Bij de meeste opdrachten deden agents met dertig uur ervaring het beter dan versies van Claude zonder die speelervaring. Zo brachten ze gemiddeld 10,3 voorwerpen naar de top van de rotszuil, tegen 3,5 voor de agents zonder speelervaring. Bij het bouwen van een zo hoog mogelijke toren was er geen duidelijk verschil.
Dat het geheugen echt het verschil maakt, lieten de onderzoekers zien door aantekeningen aan te passen. Wisten ze bij een agent de techniek om blokken uit de rots te maken, dan bouwde die agent minder torens. Haalden ze bij een andere agent een verkeerde overtuiging weg, dan ging die agent juist beter presteren. Uit die proeven blijkt ook waar nog werk ligt: de agents trekken soms te snel conclusies, en zo'n vergissing kan lang in het geheugen blijven staan.
Spelen of nadoen?
De onderzoekers zijn zelf voorzichtig. Ze beschrijven wat de agents doen, maar beweren nadrukkelijk niet dat de agents ergens plezier in hebben. Eko kreeg ook een persoonlijkheidsbestand mee dat hem beschrijft als nieuwsgierig, snel verveeld en dol op ontdekken. En als hij stilviel, kreeg hij automatisch het bericht dat hij vooral moest doorgaan met wat hij maar wilde. Dat persoonlijkheidsbestand lijkt niet de doorslag te geven: vijf agents zonder dat bestand en met kortere instructies deden ongeveer even veel verschillende dingen.
Cognitiewetenschapper Eunice Yiu van de University of California, Berkeley, die onderzoekt hoe kinderen en AI op ontdekking gaan, vindt het werk indrukwekkend. Om het echt spel te noemen, wil ze wel meer weten over wat er vanbinnen gebeurt: de agents kunnen ook gewoon de opdracht volgen of mensen nadoen. Coauteur Nathan Cloos erkent dat het een vorm van rollenspel kan zijn, maar wijst erop dat het spelen wel aantoonbaar bijdraagt aan het leren. Volgens hoogleraar en coauteur Phillip Isola heeft het systeem veel van onze cultuur geleerd, maar hangt zijn speelgedrag direct samen met wat het later beter kan.
De auteurs pleiten voor 'speeltuinen' waarin AI-agents vrij kunnen ontdekken, met goede afscherming en toezicht, omdat systemen die zelfstandig hun gang gaan ook vragen over veiligheid oproepen.
Wat betekent dit voor de weg naar de singulariteit?
AI leert nu vooral op twee manieren: door voorbeelden van mensen na te doen, of door beloningen voor goed gedrag. De MIT-onderzoekers stellen een derde weg voor: leren door te spelen, zoals kinderen dat doen. Die manier van leren wordt belangrijker nu taalmodellen steeds vaker in robots terechtkomen. Een robot in huis of in een fabriek komt altijd situaties tegen die niemand vooraf heeft bedacht. Een systeem dat uit zichzelf uitprobeert hoe de wereld werkt en dat netjes opschrijft, staat dan sterker.
Het onderzoek past bij een bredere beweging waarin AI leert in oefenwerelden, zoals de nepbedrijven vol rommelige data waarin agents leren analyseren. Het verschil is dat Eko zijn eigen oefeningen verzon. De onderzoekers vatten het mooi samen: sommige vaardigheden leer je het best met taken, andere hebben misschien iets nodig wat meer op een kindertijd lijkt.