English
Computer wint van Go-topspeler Lee Sedol, in een spel dat te groot leek voor rekenmachines
In Seoul heeft het programma AlphaGo na drie partijen de match van vijf gewonnen van Lee Sedol, een van de beste Go-spelers ter wereld. Het leerde het spel van voorbeeldpartijen en door tegen zichzelf te spelen.
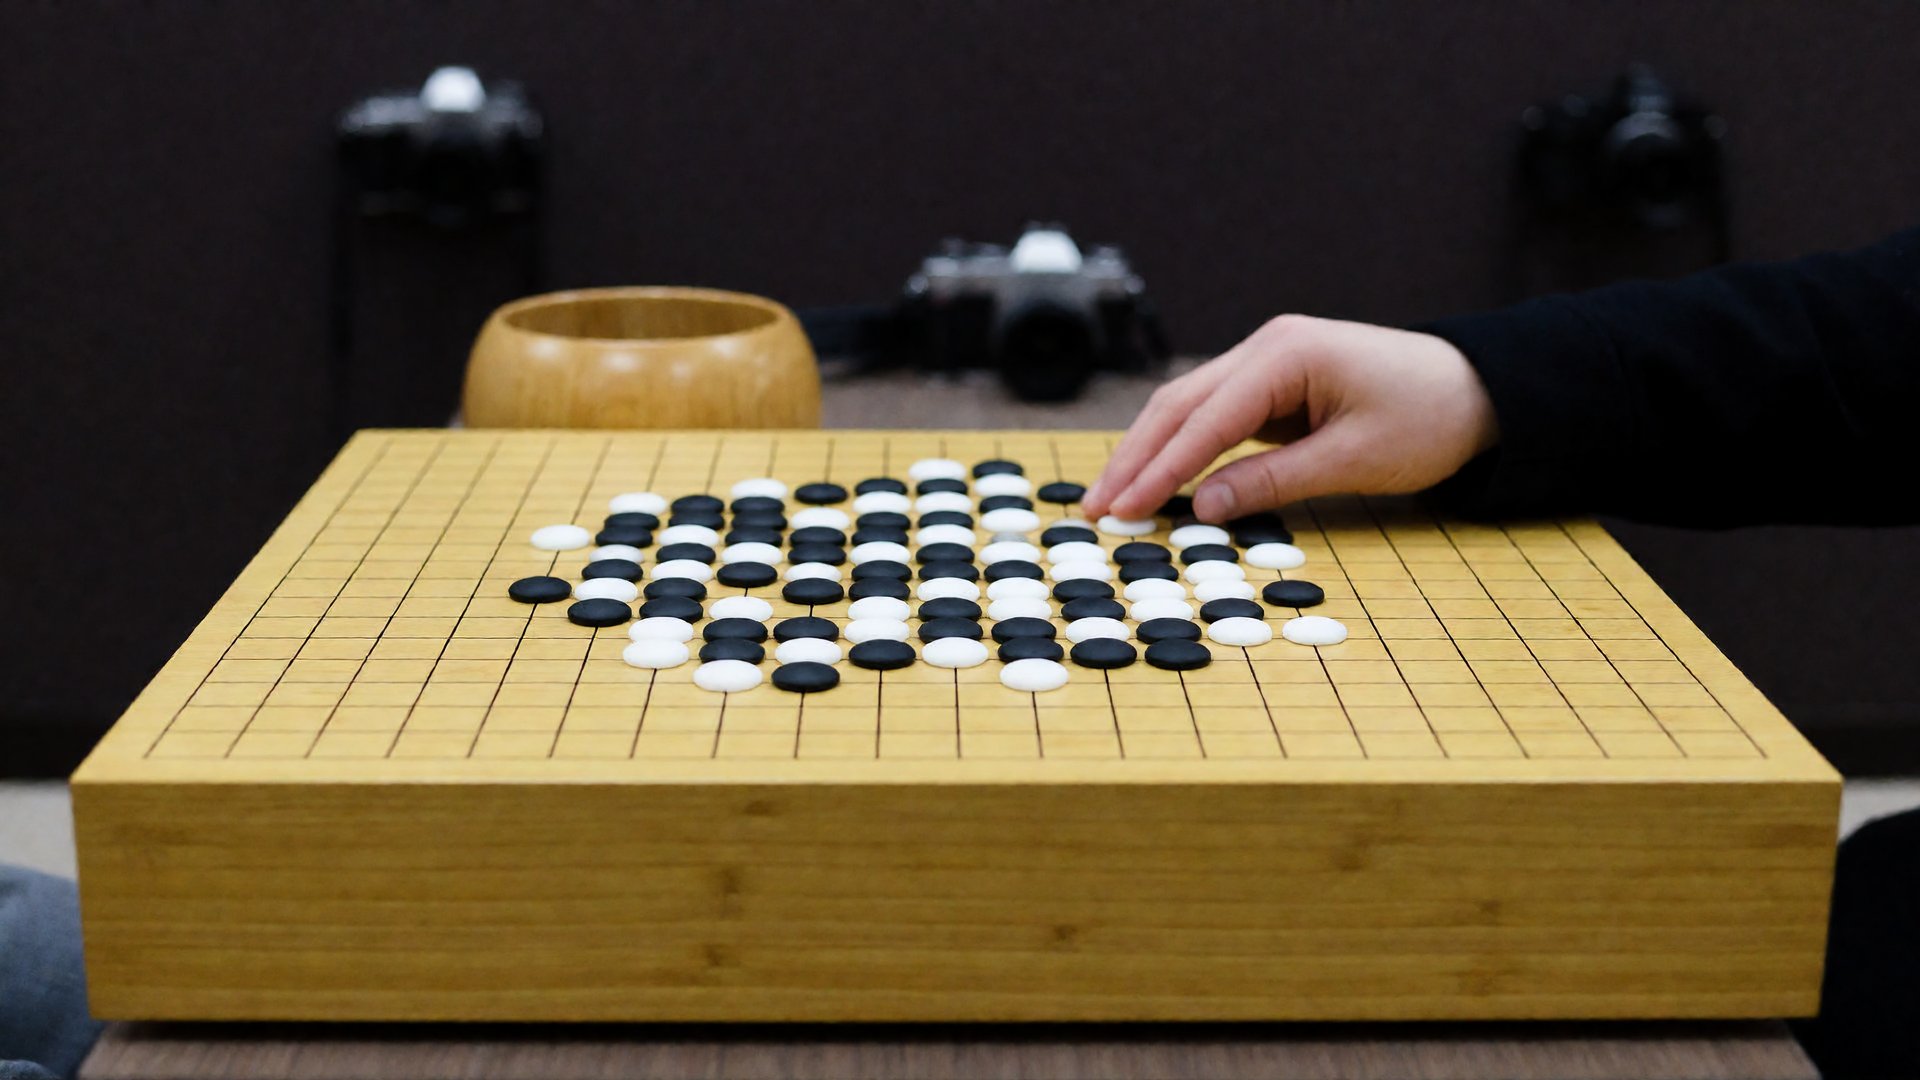
SEOUL, MAART 2016 - In een hotel in Seoul heeft een computerprogramma gewonnen van een van de beste Go-spelers ter wereld. AlphaGo, gemaakt door het bedrijf Google DeepMind, won op 12 maart de derde partij tegen de Zuid-Koreaan Lee Sedol, winnaar van 18 wereldtitels. De match bestaat uit vijf partijen, dus AlphaGo heeft hem al gewonnen. De laatste twee partijen worden nog gespeeld. Ruim 99.000 mensen keken tijdens een eerdere partij tegelijk mee via internet.
Waarom Go anders is dan schaken
Bij Go zetten twee spelers om de beurt zwarte en witte stenen op een bord met 19 bij 19 lijnen. Wie de meeste ruimte omsingelt, wint. De regels passen op een bierviltje, maar het spel is enorm: er zijn ongeveer 10^170 mogelijke stellingen, een 1 met 170 nullen erachter.
Schaakprogramma's winnen door heel veel zetten vooruit te rekenen. Zo versloeg het IBM-programma Deep Blue in 1997 schaakkampioen Garri Kasparov. Bij Go werkt dat niet: op elk moment zijn er honderden zetten mogelijk, en wie ze allemaal doorrekent, komt nooit klaar. Ook is op het bord moeilijk te zien wie er voorstaat. AlphaGo is daarom anders gebouwd.
Eerst leren van voorbeelden
AlphaGo bestaat uit neurale netwerken. Dat zijn rekenprogramma's die zichzelf bijstellen aan de hand van voorbeelden, een beetje zoals een leerling die na duizenden opgaven aanvoelt wat werkt.
De eerste stap was nabootsen. Het programma kreeg ongeveer 30 miljoen zetten te zien uit zo'n 160.000 partijen van sterke amateurspelers. Daarvan leerde het een netwerk dat bij elke stelling voorspelt welke zet een goede speler zou kiezen. Dit netwerk noemen de makers het beleidsnetwerk.
Dan tegen zichzelf spelen
Daarna liet DeepMind het programma grote aantallen partijen spelen tegen kopieën van zichzelf. Na elke partij wist het wie had gewonnen. Zetten die tot winst leidden, werden iets waarschijnlijker, zetten die tot verlies leidden iets minder. Dit heet leren met beloning: er is geen leraar die zegt wat goed is, alleen de uitslag.
Uit al die partijen leerde een tweede netwerk, het waarderingsnetwerk, om bij een stelling in te schatten hoe groot de kans is dat wit of zwart wint. Daarvoor hoeven programmeurs geen regels op te schrijven over wat een goede stelling is.
Vooruitkijken, maar alleen waar het loont
De laatste stap is zoeken. AlphaGo kijkt vooruit zoals een schaakcomputer, maar niet langs alle zetten. Het beleidsnetwerk wijst de paar veelbelovende zetten aan, en het waarderingsnetwerk beoordeelt waar die toe leiden. Zo hoeft het maar een klein deel van het bord door te rekenen.
Het programma mikt bovendien op de grootste kans om te winnen, niet op de grootste voorsprong. Daardoor kan een zet er voor een mens vreemd uitzien, ook als hij het spel veilig binnenhaalt. In de tweede partij speelde AlphaGo zo'n zet, de 37e. Volgens DeepMind was er maar 1 kans op 10.000 dat een speler die zou kiezen. Hij bleek de partij te beslissen.
Teruggeblikt vanuit 2026
Lee Sedol won de vierde partij op 13 maart met een eigen onverwachte zet, de 78e. AlphaGo won de vijfde, zodat de eindstand 4-1 werd. De Koreaanse Baduk-vereniging gaf het programma een erekwalificatie als professional van het hoogste niveau, 9 dan. Volgens DeepMind keken meer dan 200 miljoen mensen mee. Lee Sedol stopte in november 2019 als professional, omdat computers volgens hem te sterk waren geworden voor een mens.
Het belangrijkste was de aanpak. Leren van voorbeelden, daarna oefenen tegen jezelf en bijsturen op de uitslag: dezelfde bouwstenen keren terug in latere AI. Ook moderne taalmodellen worden na hun eerste training bijgeschaafd met beoordelingen, in de vorm van leren met beloning. DeepMind gebruikte dezelfde tak van onderzoek later voor het voorspellen van de vorm van eiwitten. Go bleek een eerste bewijs dat zulke programma's een probleem kunnen aanpakken waar niemand een handleiding voor had.