d-Matrix verdeelt het werk van een AI-model over twee soorten chips voor snellere antwoorden
Het Amerikaanse chipbedrijf d-Matrix liet op een grote datacenterbeurs zien hoe een AI-model sneller antwoordt als gewone grafische chips en eigen chips elk het werk doen waar ze goed in zijn. Het bedrijf levert nu ook complete rekenclusters.
Een AI-chatbot schrijft zijn antwoord woord voor woord. Elk nieuw stukje tekst vraagt een complete rekenronde door het hele model. Hoe sneller die ronde gaat, hoe vlotter het antwoord op je scherm verschijnt. Voor AI-agents die zelf code schrijven of taken uitvoeren telt dat extra, omdat ze vaak duizenden van zulke rondes achter elkaar draaien.
Het Amerikaanse chipbedrijf d-Matrix denkt dat het sneller kan door het werk slim te verdelen over twee soorten chips. Het bedrijf liet dat half oktober 2026 live zien op de OCP Global Summit in San Jose, een grote jaarlijkse beurs over datacenters.
Twee soorten werk in één model
Veel nieuwe taalmodellen zijn gebouwd als een team van specialisten, een zogeheten mixture of experts. Voor elk woord kiest het model een paar 'experts' uit een grote groep, en alleen die rekenen mee. Dat bespaart rekenwerk.
In zo'n model zitten grofweg twee soorten stappen. In de eerste stap kijkt het model terug naar alles wat er al in het gesprek staat. In de tweede stap doen de gekozen experts hun werk. Die tweede stap vraagt vooral dat de chip heel snel bij zijn geheugen kan. Dat is te vergelijken met een kok die steeds iets uit de voorraadkast moet pakken: hoe dichter de kast bij het fornuis staat, hoe sneller het gerecht klaar is.
Grafische chips en eigen chips samen
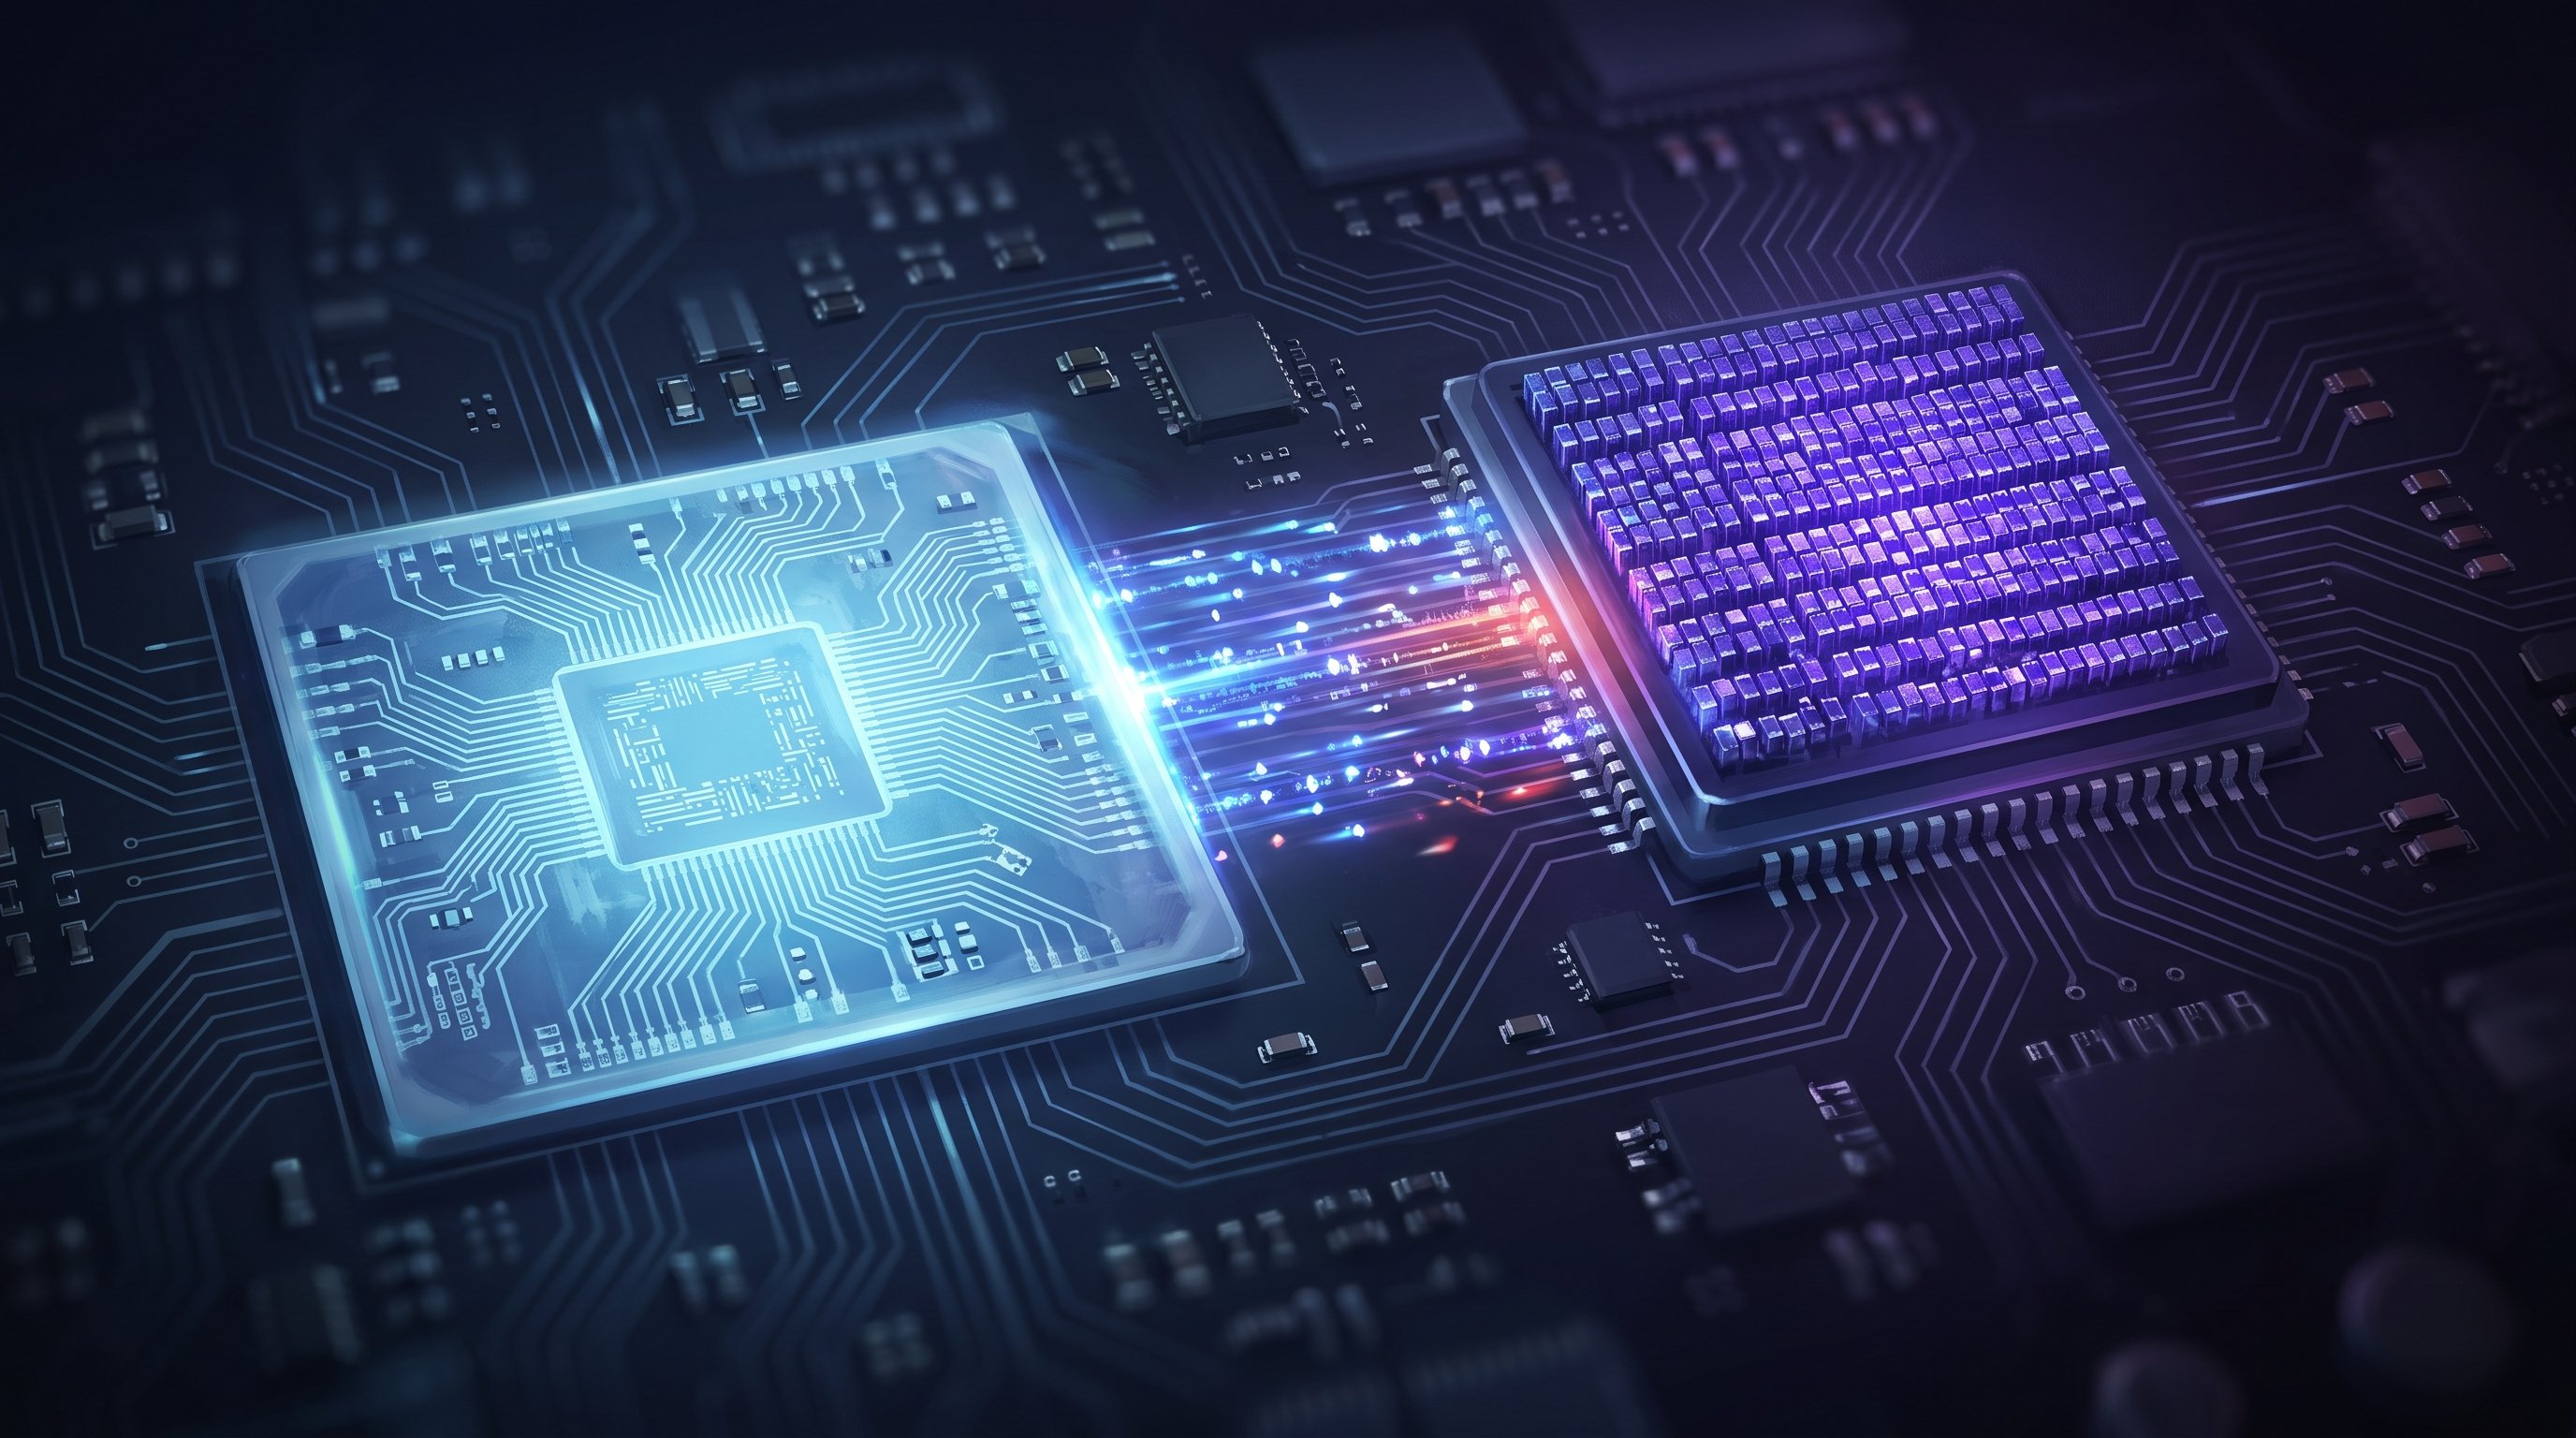
Bij de demonstratie draaide de eerste stap op bekende grafische chips van Nvidia, de H100. De stap van de experts ging naar Corsair, de eigen chip van d-Matrix. Die heeft zijn geheugen direct op de chip zelf, waardoor gegevens veel sneller beschikbaar zijn. Het bedrijf gebruikte een open taalmodel met ongeveer 20 miljard rekenwaarden.
Volgens d-Matrix haalde de combinatie 845 stukjes tekst per seconde per gebruiker, en samen ruim 20.000 per seconde bij 64 gebruikers tegelijk. Het bedrijf zegt dat het de eerste is die deze manier van werk verdelen live laat zien op chips die al te koop zijn. Tot nu toe was het vooral een idee uit wetenschappelijke artikelen.
Hele rekenclusters
Op dezelfde beurs kondigde d-Matrix Squadron aan: complete clusters van maximaal 16 serverrekken met samen 1.024 Corsair-chips. De systemen worden met lucht gekoeld en passen daardoor in bestaande datacenters, zonder nieuwe waterkoeling. D-Matrix bouwde ze samen met de bedrijven Arista, Broadcom en Supermicro. Losse servers en rekken zijn al te koop; de grote clusters gaan eerst naar een kleine groep klanten. Topman Sid Sheth zegt dat het bedrijf zo verandert van chipmaker naar leverancier van complete rekenkracht voor datacenters.
Eerder dit jaar maakte het AI-bedrijf Parasail al bekend dat het chips van d-Matrix naast Nvidia-chips gebruikt om AI-modellen te draaien.
Kanttekeningen en vervolgstappen
De snelheidscijfers komen van d-Matrix zelf. Onafhankelijke metingen moeten laten zien hoeveel winst klanten in de praktijk halen. De aanpak werkt ook alleen bij modellen die met experts werken, al zijn dat er steeds meer. D-Matrix wil de methode nu toepassen op grotere modellen, en eind 2027 moet een nieuwe generatie chips volgen.
Het is een van de vele pogingen om AI-modellen sneller en zuiniger te laten draaien. Ook in China wordt hard gewerkt aan eigen rekenkracht, zoals bij het cluster van Sugon met 100.000 AI-chips.
Wat betekent dit voor de weg naar de singulariteit?
AI wordt steeds vaker niet alleen getraind, maar vooral gebruikt: miljoenen mensen en agents stellen elke seconde vragen. Daardoor verschuift de race van 'wie bouwt het grootste model' naar 'wie laat het model het snelst en zuinigst draaien'. Het idee van d-Matrix is eenvoudig en krachtig: geef elk deel van het werk aan de chip die er het best in is, in plaats van alles op één soort chip te doen.
Als zulke gemengde systemen hun beloftes waarmaken, worden AI-agents vlotter en goedkoper. Een agent die in een paar minuten doet waar hij nu een uur over doet, kan veel meer proberen, controleren en verbeteren. Dat soort snelheid is precies wat nodig is om AI echt als werkpartner in te zetten.