English
NVIDIA laat grafische chips ook gewone berekeningen doen
NVIDIA presenteert CUDA: met de programmeertaal C kunnen ontwikkelaars de honderden rekenkernen van een grafische chip inzetten voor allerlei berekeningen, niet alleen voor beeld. Volgens het bedrijf tot 100 keer sneller.
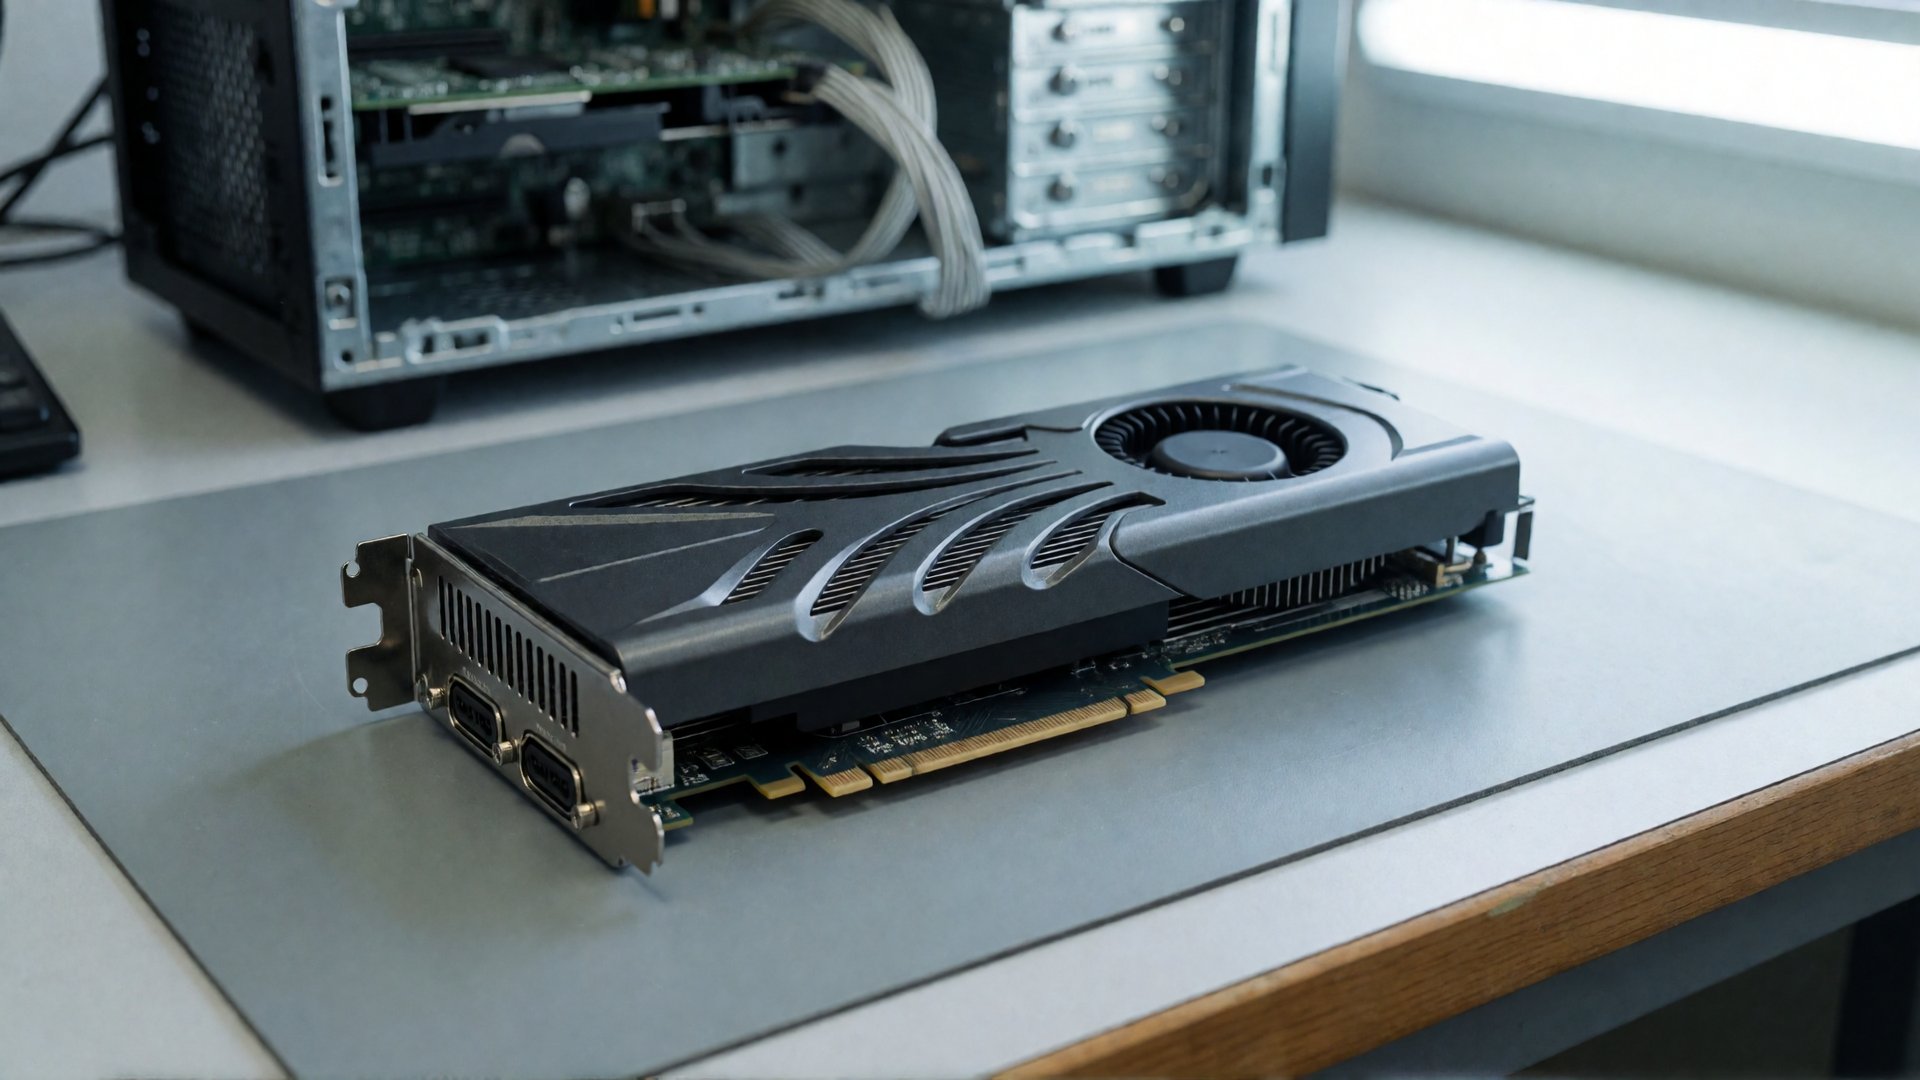
THEALE, NOVEMBER 2006 - De chipmaker NVIDIA heeft CUDA aangekondigd, een nieuwe manier om de grafische chip van een computer voor allerlei berekeningen te gebruiken. Tot nu toe dienen die chips vooral om beeld te maken voor spellen en ontwerpprogramma's. Met CUDA kunnen programmeurs er ook gewone rekenwerk aan geven. Volgens NVIDIA kunnen moeilijke problemen daardoor tot 100 keer sneller worden opgelost dan met de gebruikelijke aanpak.
Eén snelle rekenaar of heel veel kleine
Een gewone processor in een computer, de CPU, lijkt op een handige alleskunner. Hij voert een paar taken tegelijk uit en doet die razendsnel, een voor een. Een grafische chip, de GPU, is anders gebouwd. Om een beeld op het scherm te zetten, moet de kleur van elk van de miljoenen puntjes worden uitgerekend. Dat zijn allemaal eenvoudige sommen die op elkaar lijken. Daarom bestaat een grafische chip uit heel veel kleine rekeneenheden die tegelijk werken. De nieuwe GeForce 8800 heeft er 128, die elk 1,35 gigahertz halen.
Het ontbrekende stuk: een gewone taal
Veel problemen buiten het beeld bestaan ook uit enorme aantallen vergelijkbare sommen op veel gegevens. Wie een grafische chip daarvoor wilde gebruiken, moest het werk nog verpakken als een beeldprobleem. Dat vroeg kennis van grafisch programmeren. CUDA haalt die drempel weg. NVIDIA levert een compiler voor de bekende programmeertaal C. Een compiler vertaalt de tekst van een programmeur naar opdrachten die de chip begrijpt. Een programmeur schrijft dus gewoon C, en de chip rekent.
Duizenden draden tegelijk
Het werk wordt verdeeld in draden: kleine rijen opdrachten die elk een stukje van de som uitvoeren. Duizenden draden lopen tegelijk. Bij beeldverwerking, bijvoorbeeld, hoeven de draden niet met elkaar te praten, omdat elk puntje apart wordt bewerkt. Voor lastiger problemen is er een gedeeld geheugen op de chip, de Parallel Data Cache. Daardoor kunnen de 128 rekenkernen samenwerken. De ontwikkelingsset voor CUDA is beschikbaar voor ontwikkelaars en onderzoekers die zich aanmelden.
Bedrijven als Acceleware en Headwave verwachten dat het hun klanten voordeel oplevert.
Teruggeblikt vanuit 2026
CUDA werd in februari 2007 openbaar. In 2012 trainde het Toronto-team van AlexNet zijn netwerk op twee NVIDIA-grafische kaarten, en won daarmee een wedstrijd in beeldherkenning. Het trainen van een neuraal netwerk bestaat uit gigantische aantallen vermenigvuldigingen die op elkaar lijken, precies het soort werk waarvoor een grafische chip is gebouwd. Vanaf ongeveer 2015 richtte de ontwikkeling van CUDA zich steeds meer op machine learning en neurale netwerken.
Zo kwam een techniek voor beeld en spellen, samen met een programmeertaal die iedereen kon gebruiken, uit bij het trainen van de grootste AI-modellen.