English
Taalmodel
Een taalmodel is een AI-model dat getraind is op enorme hoeveelheden tekst en daardoor tekst kan begrijpen, schrijven en vertalen. De chatbots die je kent, draaien op een taalmodel.
Een taalmodel is een AI-model dat heeft geleerd van enorme hoeveelheden tekst. Het kan daardoor vragen beantwoorden, teksten schrijven en samenvatten, vertalen en programmeercode maken. De bekende chatbots draaien op een taalmodel. Bij een groot taalmodel, in het Engels large language model of LLM, zijn zowel het model zelf als de hoeveelheid tekst waarmee het is getraind heel groot.
Hoe werkt het?
In de kern leert een taalmodel het volgende stukje tekst te voorspellen. Het leest een stuk tekst, gokt wat er hierna komt en kijkt hoe ver het ernaast zat. Dit gebeurt miljarden keren. Zo pikt het patronen op in taal, maar ook in de kennis die in die teksten staat. De tekst wordt daarbij in kleine stukjes gehakt, de tokens, en het model werkt met die stukjes.
Wat het model heeft geleerd, zit in zijn parameters: miljarden getallen. Een antwoord ontstaat meestal stukje voor stukje, waarbij elk nieuw stukje afhangt van wat er al staat. Er bestaan ook modellen die het anders doen. Mercury 3 van het Amerikaanse Inception maakt eerst een ruwe versie van de hele tekst en scherpt die in een paar rondes aan. Volgens het bedrijf is het model daardoor vier tot acht keer zo snel als vergelijkbare modellen (link).
Waarom het ertoe doet
Taalmodellen zijn de motor achter bijna alle AI-nieuws. Ze vormen de basis van AI-agents die zelfstandig taken uitvoeren. Ze worden ook ingezet in de wetenschap, bijvoorbeeld om eiwitten te ontwerpen of experimenten te bedenken.
Het trainen van zo'n model kost veel rekenkracht, en daar wordt hard aan gewerkt. Microsoft AI rondde de eerste trainingsfase van zijn basismodel MAI-Base-2 af. Volgens het bedrijf haalt het model hetzelfde niveau als een sterk Chinees model, met 4 tot 12 keer minder rekenwerk (link). Hoe goed een taalmodel is, meten onderzoekers met vaste toetsen, de benchmarks.
Artikelen over Taalmodel
-
AI-model ontwerpt werkende eiwitten op basis van een zin in gewone taal
Chinese onderzoekers maakten een AI-model dat eiwitten ontwerpt vanuit een beschrijving in gewone taal. In vier proeven deed het resultaat ook echt wat er gevraagd was: licht geven, plastic afbreken, alcohol omzetten en CO2 helpen vastleggen.
-
AI-model getraind op bijna vier miljoen fossielen werpt nieuw licht op grote uitstervingsgolven
Chinese onderzoekers trainden een AI-model op bijna vier miljoen fossielen. Het brengt de geschiedenis van het leven in ongekend detail in kaart en wijst erop dat drie van de vijf grote uitstervingsgolven geleidelijker verliepen dan gedacht. Andere paleontologen zijn wat terughoudender.
-
Andere volgorde laat AI-servers ruim drie keer sneller beginnen met antwoorden
Ingenieurs van Amazon en Mistral hebben de open software vLLM, waarmee veel bedrijven AI-modellen draaien, slimmer laten samenwerken. Bij lange vragen verscheen het eerste woord van het antwoord in hun test ruim drie keer sneller. De nieuwe werkwijze is gratis te gebruiken.
-
Groot open AI-model van DeepSeek past nu op een computer met 128 gigabyte geheugen
Het nieuwe open AI-model van DeepSeek is te groot voor een gewone computer. Het bedrijf Unsloth maakte er een sterk verkleinde versie van die op een krachtige laptop of minicomputer met 128 gigabyte geheugen draait. Dat kost wat nauwkeurigheid.
-
Vier AI-agents spelen samen Minecraft uit met zelfgeschreven programma's
Vier AI-agents van Google DeepMind hebben Minecraft zelfstandig uitgespeeld. In ruim 27 uur verdeelden ze het werk via de chat, schreven ze 2.783 eigen programma's en versloegen ze de eindbaas. Ze speelden op de makkelijke stand, met software die precies vertelt wat er om hen heen is.
-
AI-model Mercury 3 schrijft ruim duizend woorddelen per seconde door de hele tekst tegelijk te maken
Het Amerikaanse Inception heeft Mercury 3 uitgebracht, een taalmodel dat niet woord voor woord schrijft maar een hele tekst in een paar stappen scherp stelt. Volgens het bedrijf is het daardoor vier tot acht keer zo snel als vergelijkbare modellen.
-
Onderzoeker zegt: het binnenwerk van AI is veel beter te begrijpen dan we dachten
Nick Cammarata van het AI-bedrijf Goodfire stelt dat de 'neuronen' in AI-modellen meestal één duidelijke taak hebben. Als dat klopt, wordt het veel makkelijker om in een AI-model te kijken en te controleren wat het doet. Andere experts noemen het werk interessant, maar willen eerst meer bewijs zien.
-
d-Matrix verdeelt het werk van een AI-model over twee soorten chips voor snellere antwoorden
Het Amerikaanse chipbedrijf d-Matrix liet op een grote datacenterbeurs zien hoe een AI-model sneller antwoordt als gewone grafische chips en eigen chips elk het werk doen waar ze goed in zijn. Het bedrijf levert nu ook complete rekenclusters.
-
Chinees bedrijf Sugon laat rekencluster met 100.000 eigen AI-chips zien
Het Chinese Sugon toont zijn Sugon 8000: een rekencluster dat 100.000 rekenkaarten uit eigen land koppelt. Het systeem combineert AI en klassieke supercomputers en heeft volgens Sugon al tien onderzoeksprojecten gedraaid.
-
Natuurkundige laat AI rekenmethodes tussen vakgebieden uitwisselen: 36 artikelen in drie maanden
Harvard-natuurkundige Matthew Schwartz liet het AI-model Claude rekentrucs uit het ene vakgebied toepassen in een ander. Met 19 collega's leverde dat in drie maanden 36 wetenschappelijke artikelen op, van zonnevlekken met een levensverwachting tot een regenwoud dat sneller verandert dan gedacht.
-
Microsoft vindt zuiniger recept om grote AI-modellen te trainen
Microsoft AI heeft de eerste trainingsfase van zijn nieuwe basismodel MAI-Base-2 afgerond. Volgens het bedrijf haalt het met zijn nieuwe aanpak hetzelfde niveau met 4 tot 12 keer minder rekenwerk dan een sterk Chinees model. Het model wordt nu verder getraind.
-
Chinees bedrijf MiniMax brengt snel en goedkoop AI-model uit voor agents
Het Chinese AI-bedrijf MiniMax heeft M3.1 Flash uitgebracht, een model voor AI-agents die zelfstandig taken uitvoeren. Volgens MiniMax is het bijna drie keer zo snel als zijn voorganger en kost een agenttaak 70 procent minder. Onafhankelijke tests volgen nu.
-
Nvidia brengt open AI-modellen uit voor digitale assistenten op servers en laptops
Nvidia heeft drie nieuwe open AI-modellen uitgebracht voor assistenten die zelfstandig taken uitvoeren. Het grootste draait in het datacenter van bedrijven, de kleinere werken gewoon op een laptop. Volgens Nvidia verslaat het grote model na extra training topmodellen op specialistische taken.
-
Leert Claude door te spelen op een onbewoond eiland?
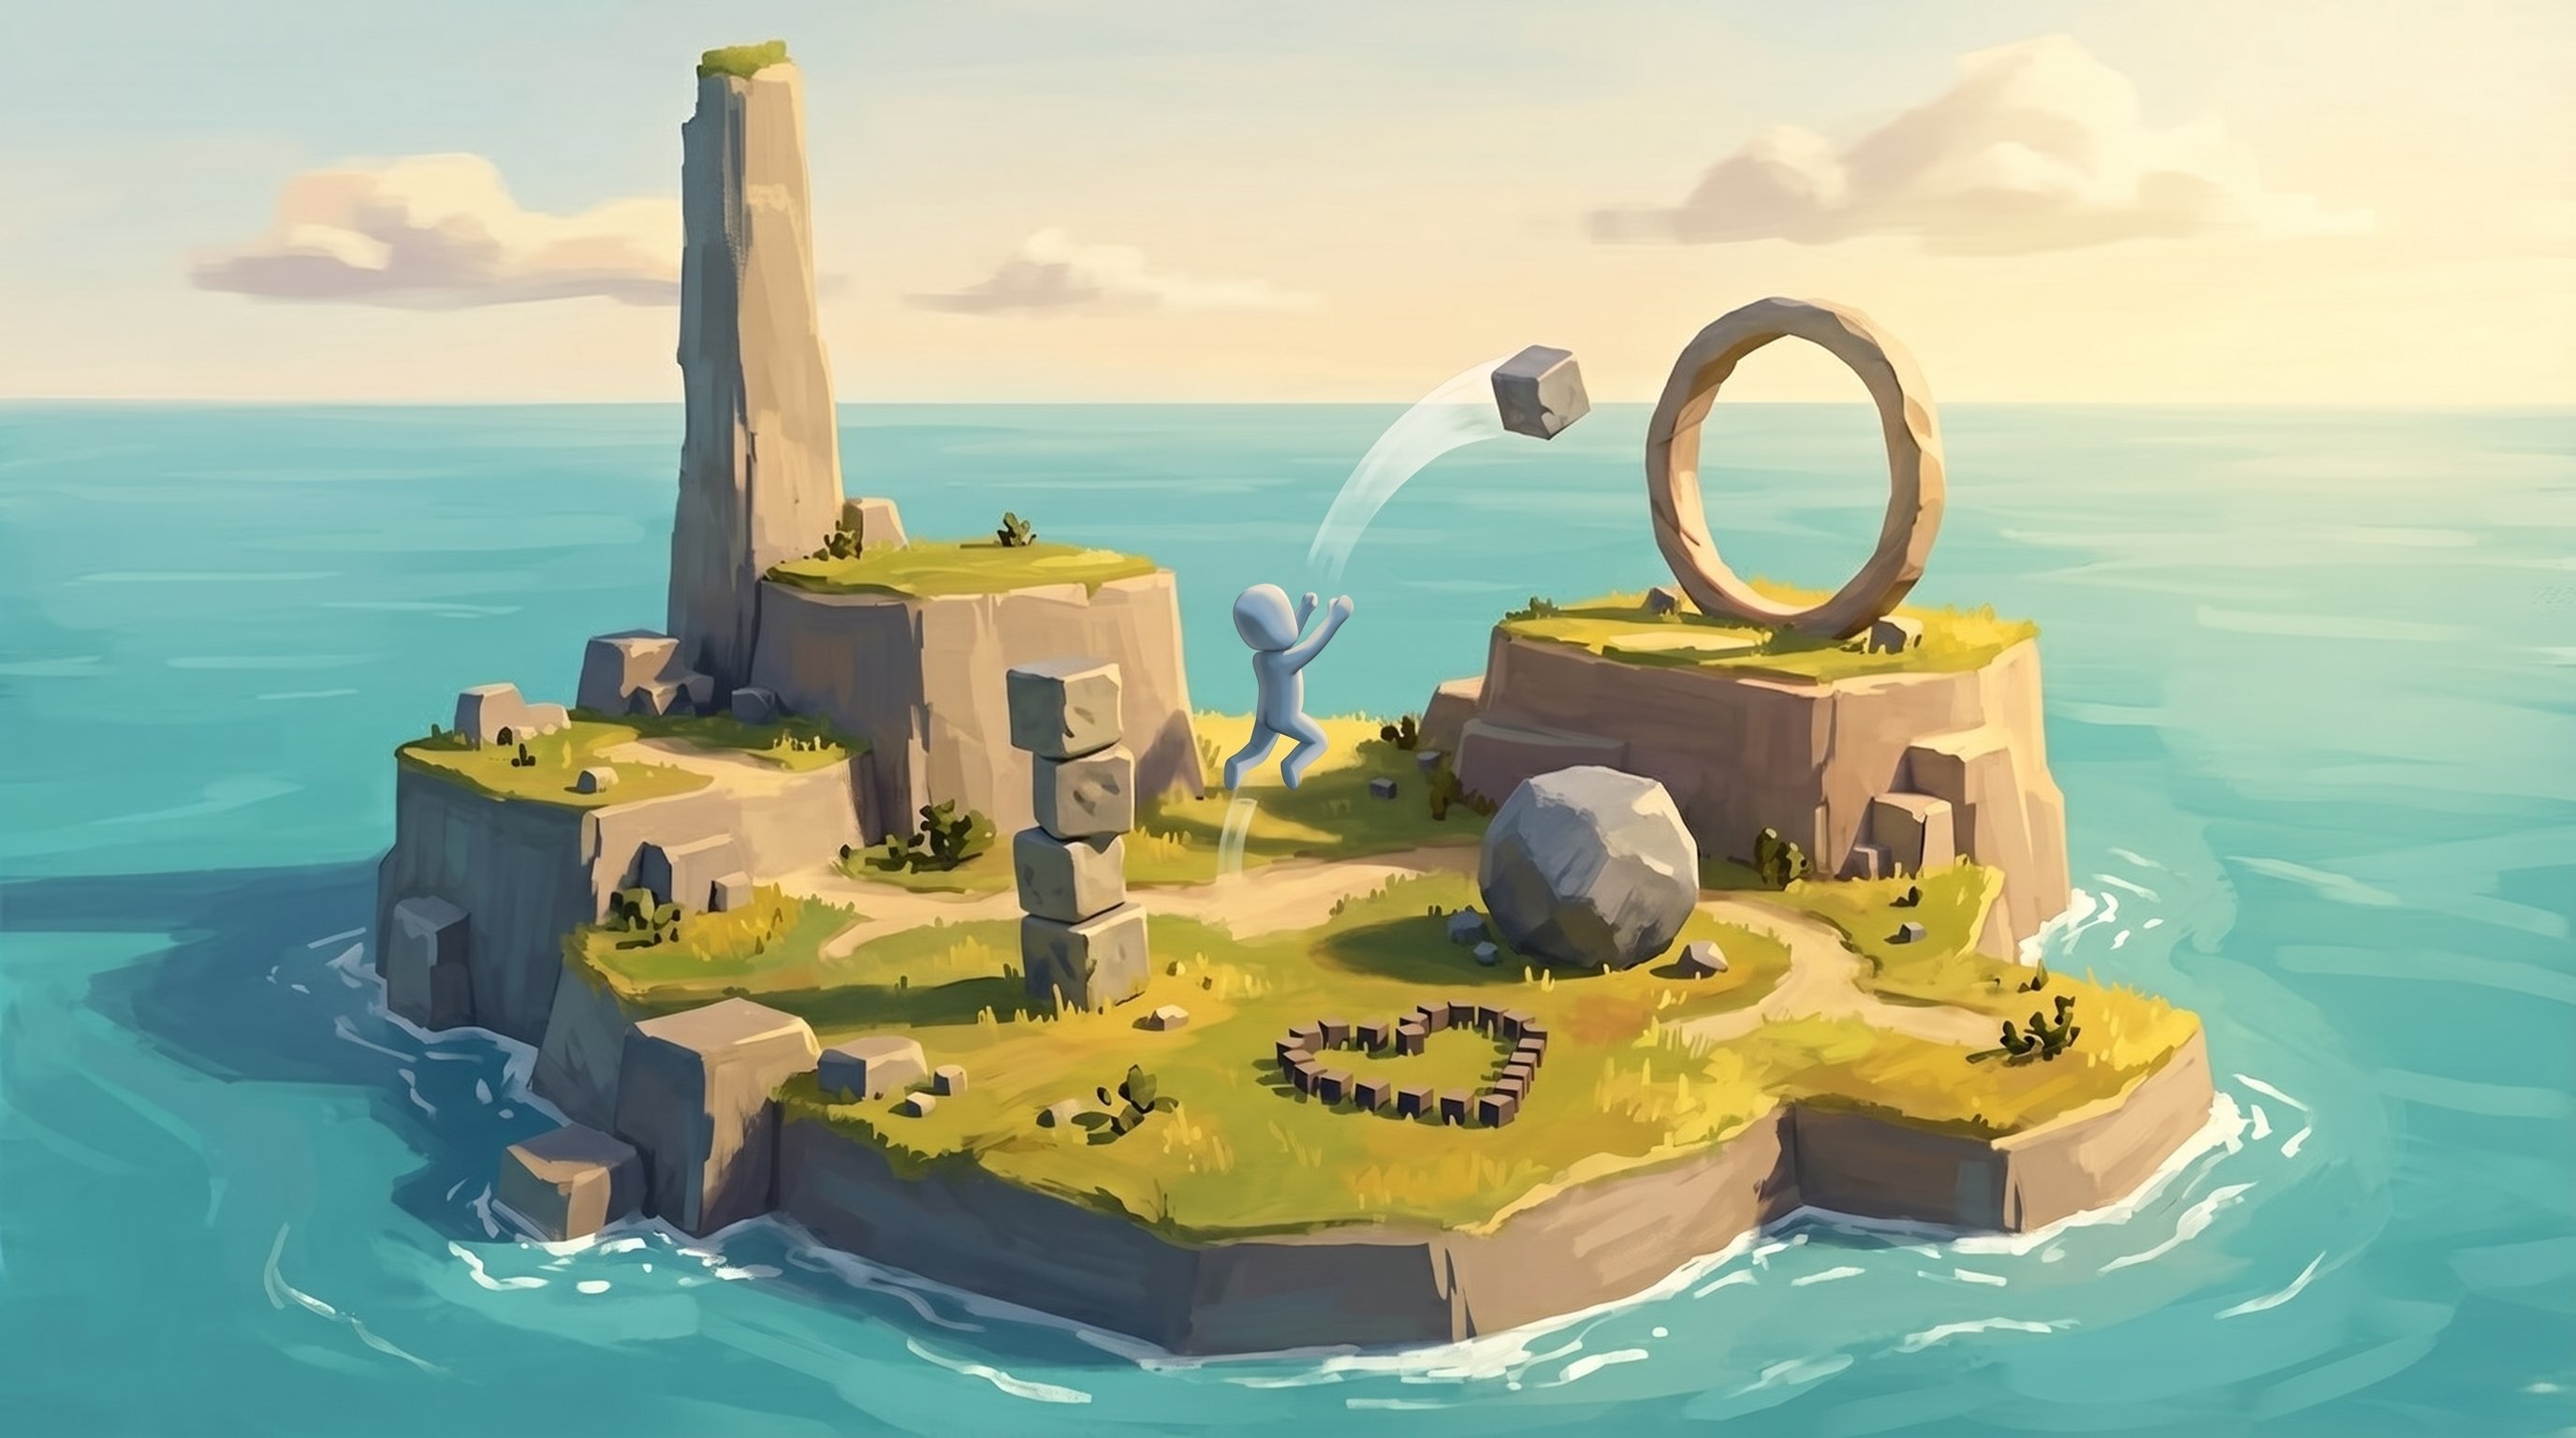
Onderzoekers van MIT lieten AI-assistent Claude dertig uur zonder opdracht los op een virtueel eiland. Hij bedacht zelf spelletjes, legde tekeningen met blokken en deed proefjes. Met die ervaring deed hij het later bij de meeste nieuwe taken beter dan een versie van Claude zonder die speelervaring.
-
Verzonnen bedrijfsdata met een bekend antwoord leren AI-agents beter analyseren
Onderzoekers van Meituan en Chinese universiteiten bouwen nepwerelden vol rommelige bestanden, waarvan ze precies weten wat erachter zit. Zo kun je controleren of een AI-agent echt de goede conclusie trekt. Een model dat ermee oefende, werd duidelijk beter in data-analyse.