English
Woordenlijst bij AI
Versterkend leren
Bij versterkend leren leert een AI door te proberen: goede acties worden beloond, slechte niet. Zo verbetert het systeem zichzelf stap voor stap.
Versterkend leren (Engels: reinforcement learning) is een manier om een AI iets te leren door uitproberen. Het systeem krijgt geen voorbeeldantwoorden, maar een beloning als het iets goed doet. Het zoekt zelf uit welke acties tot die beloning leiden.
Hoe werkt het?
Denk aan een hond die een trucje leert: doet hij het goed, dan krijgt hij een koekje. Een AI werkt vergelijkbaar. Het systeem probeert een actie, kijkt wat het resultaat is en krijgt een getal als beloning of straf. Na heel veel pogingen, vaak in een computersimulatie, onthoudt het welke keuzes het meeste opleveren.
Dat is handig voor taken waarbij niemand precies kan voorschrijven hoe het moet, zoals lopen met een robot, een spel winnen of een lange reeks stappen plannen.
Waarom het ertoe doet
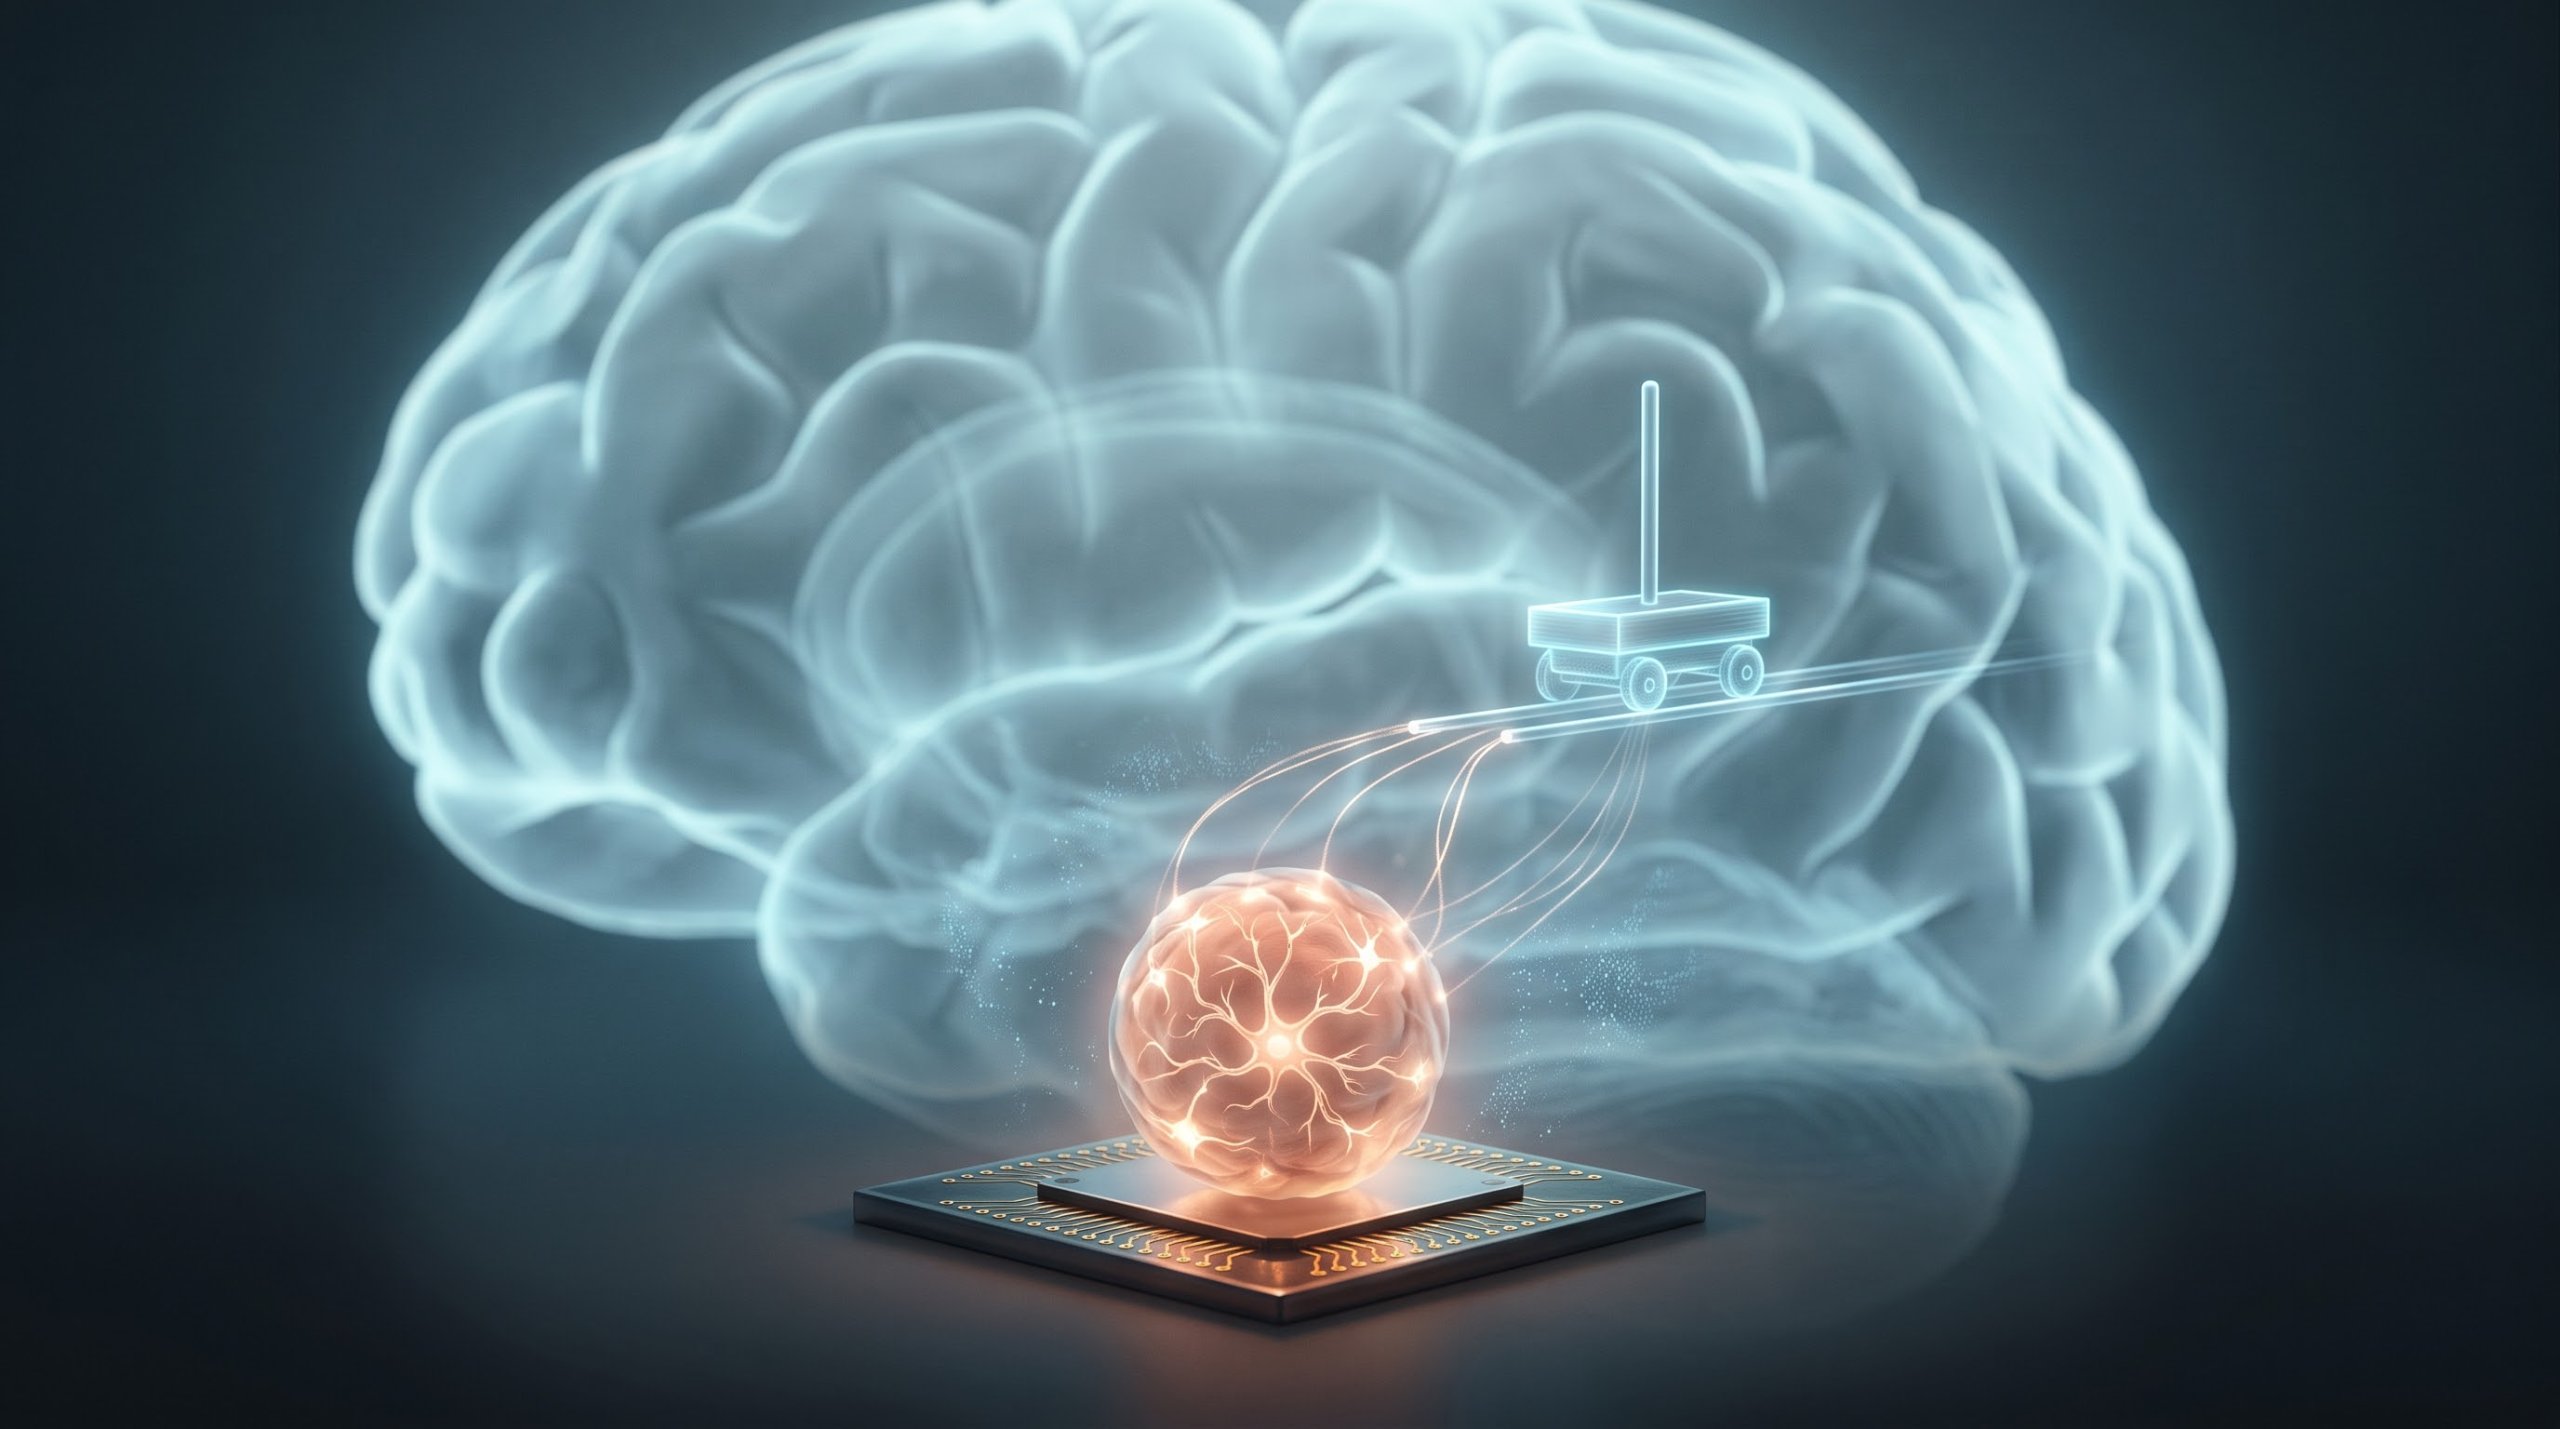
Versterkend leren duikt op in heel verschillende hoeken van de wetenschap. Onderzoekers van de University of California in Santa Cruz lieten gekweekt hersenweefsel een virtueel karretje met een stok in evenwicht houden. Een AI-algoritme dat leert door uitproberen bepaalde welke zenuwcellen een trainingssignaal kregen, een soort kunstmatige coach.
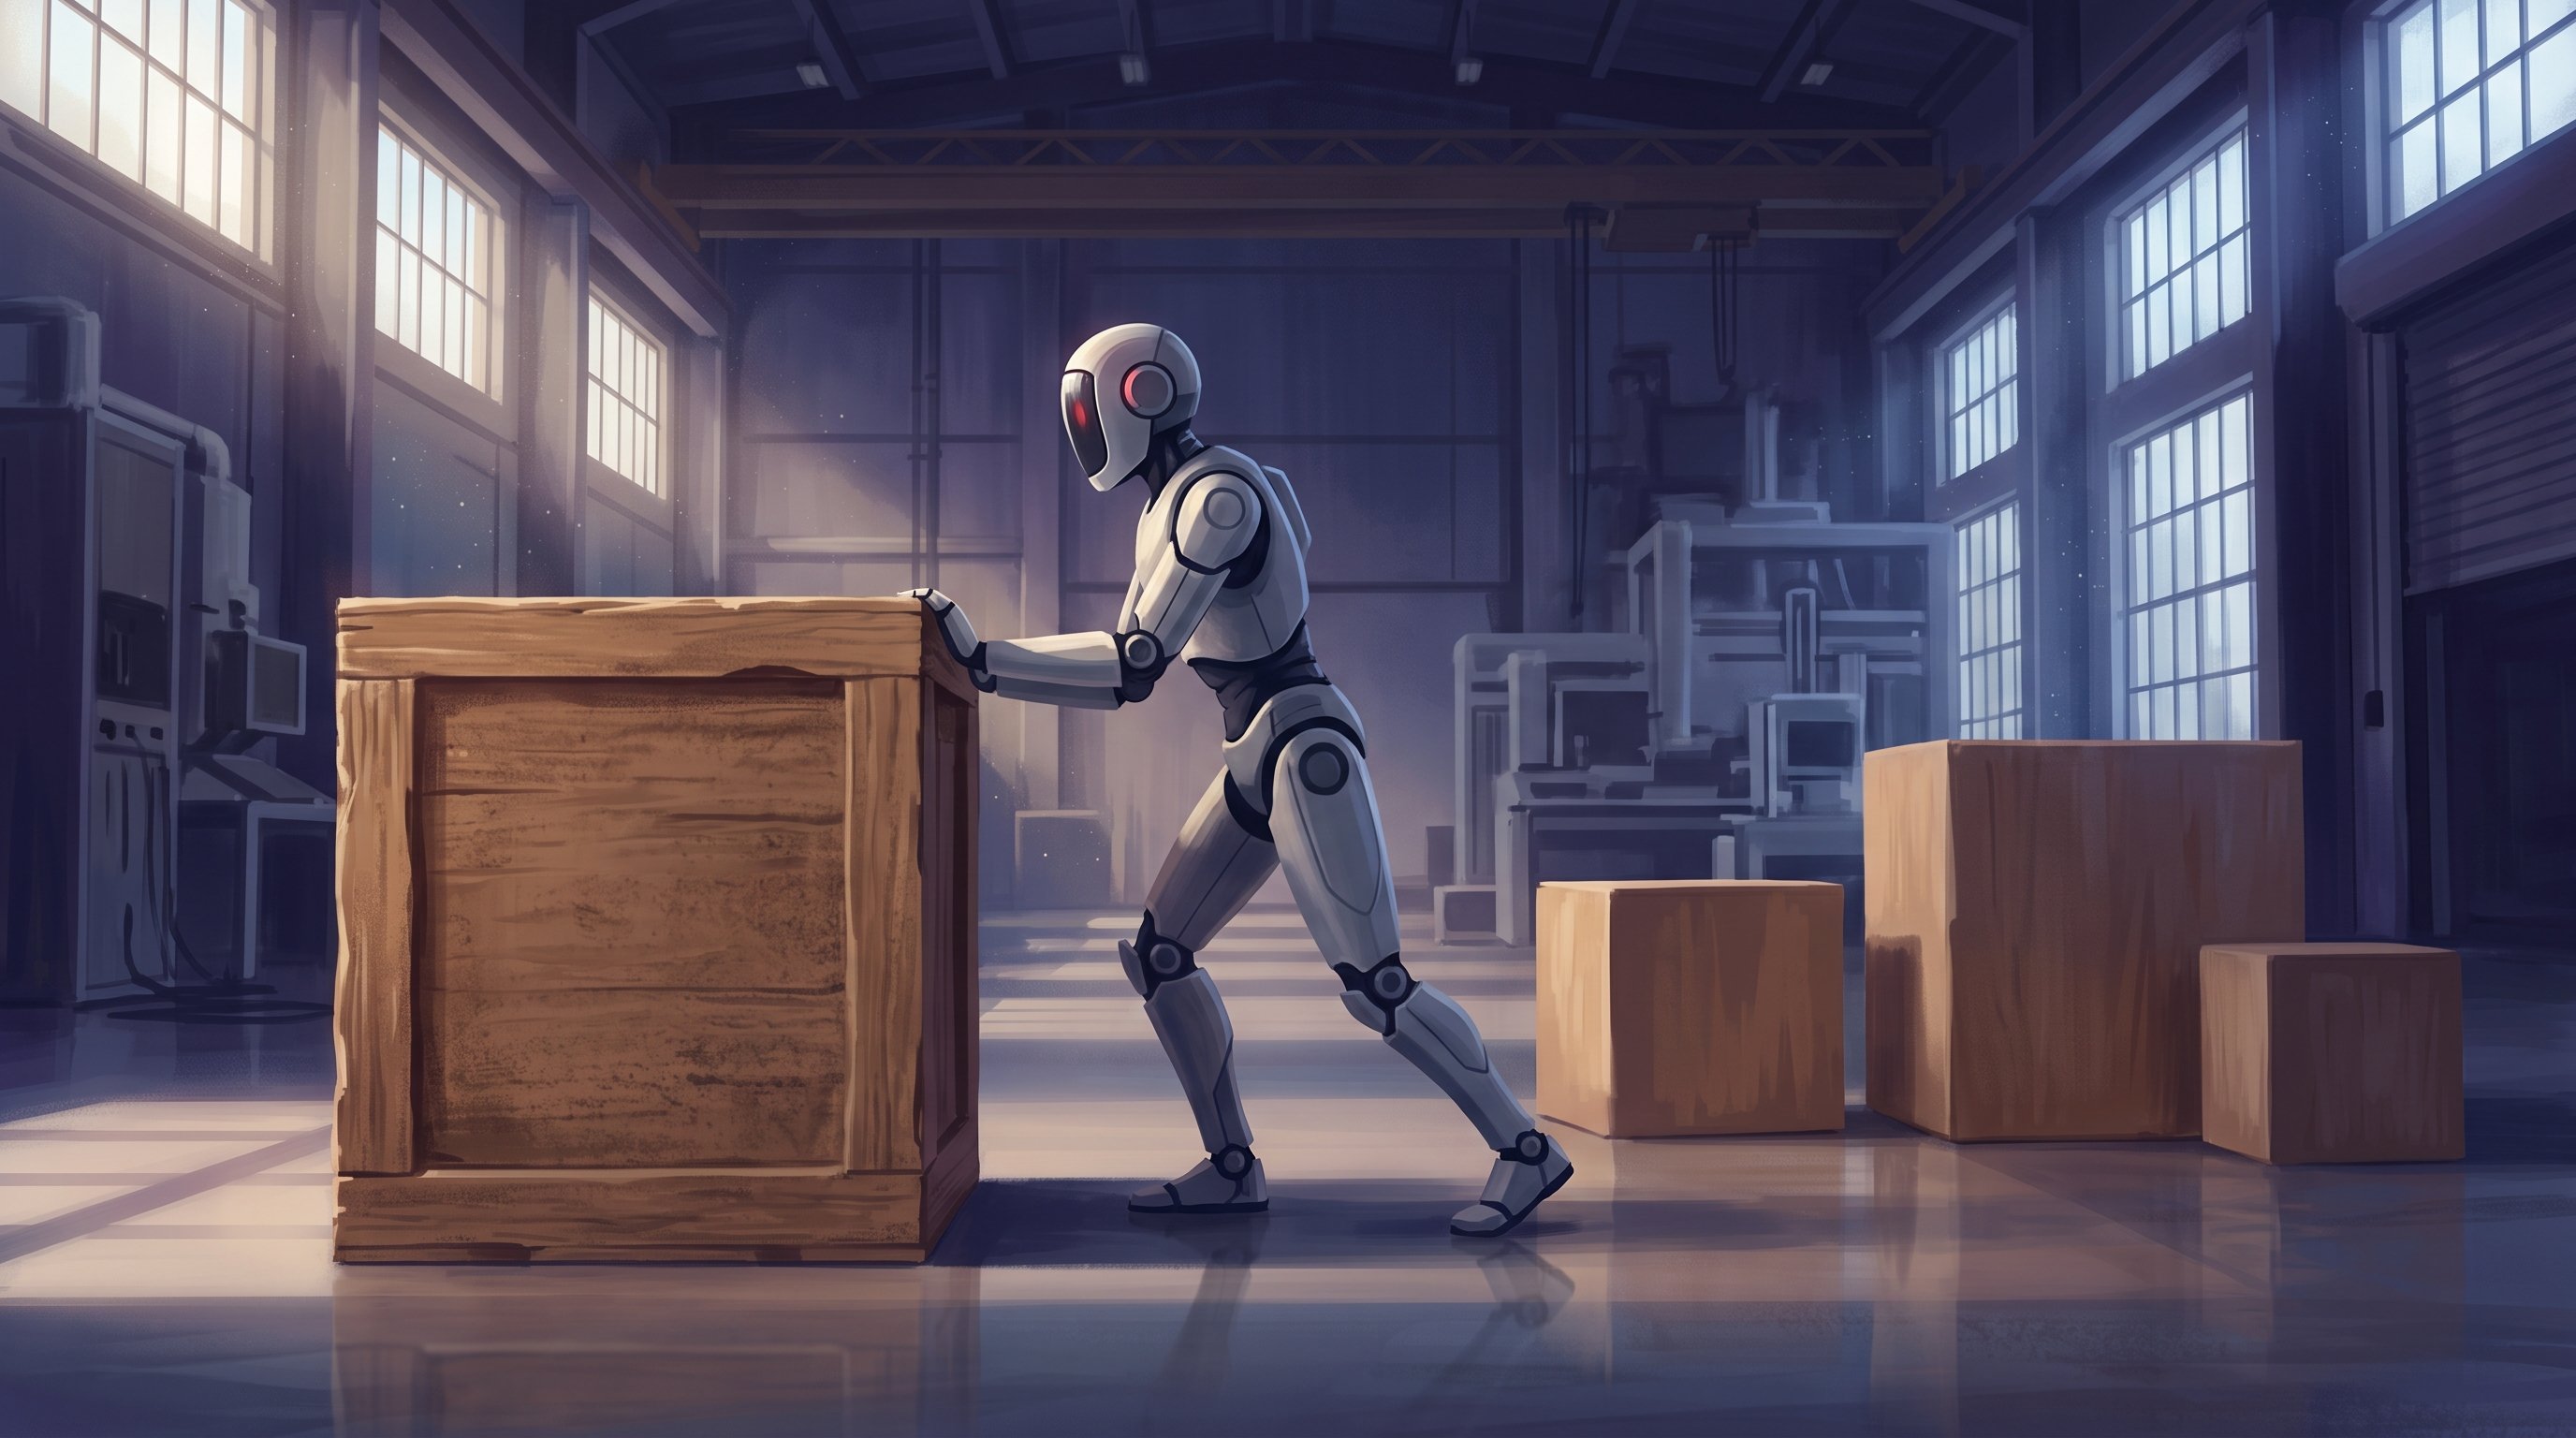
Ook in de robotica is het een standaardmethode. Het Koreaanse instituut KAIST liet in oktober 2026 een mensachtige robot zien die al lopend zware voorwerpen duwt en tilt. De robot oefent in een simulatie heel vaak dezelfde taak en krijgt een beloning als het goed gaat. Eén AI-systeem stuurt daardoor benen en armen tegelijk aan.
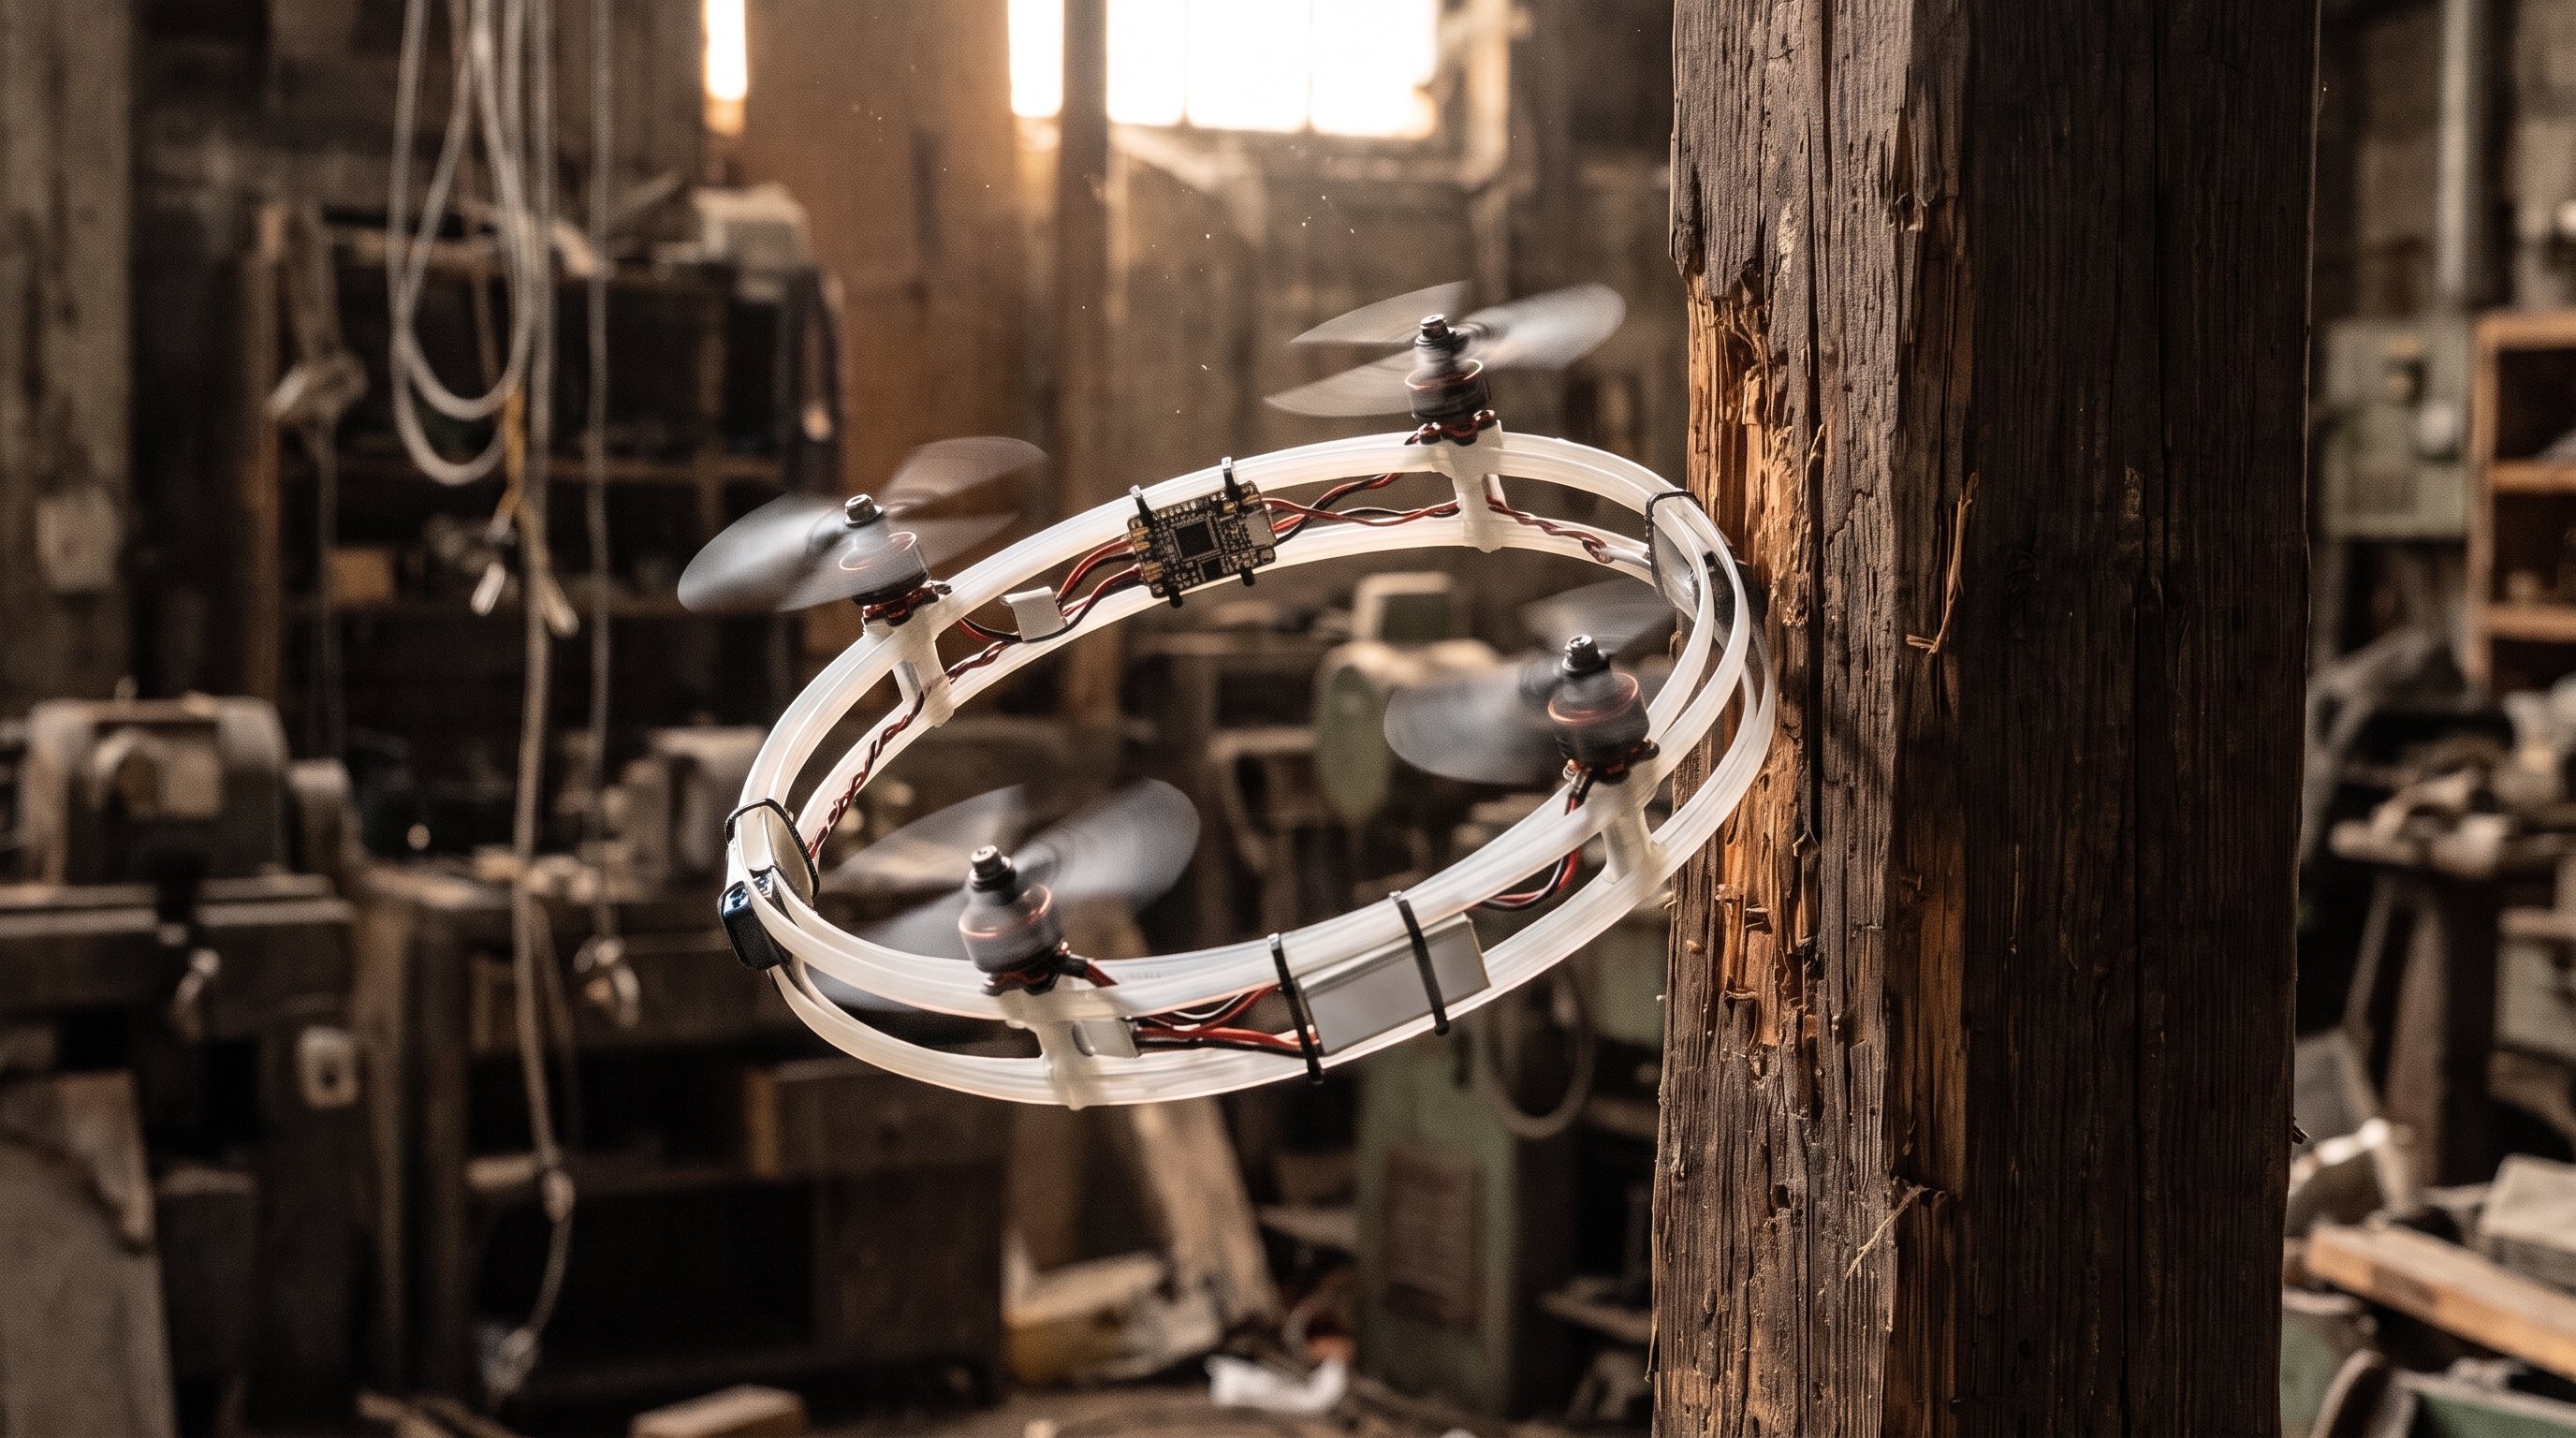
Ook bij drones werkt het zo. Onderzoekers van ETH Zürich bouwden FlexiQuad, een drone met een zachte, ringvormige constructie die tegen botsingen kan. Na een klap trilt het buigzame frame nog even na, waardoor camerabeelden wazig worden en zelfstandig navigeren lastiger wordt. Het team leert de drone met versterkend leren om na een botsing weer stabiel te vliegen, met alleen zijn eigen bewegingssensoren.
Artikelen over Versterkend leren
-
FlexiQuad: ETH Zürich bouwt zachte drone die tegen een botsing kan
Onderzoekers van ETH Zürich bouwden FlexiQuad, een drone met een buigzaam ringvormig frame. Bij een botsing veert het frame mee in plaats van te breken. Het prototype van 405 gram haalt toch meer dan 80 kilometer per uur.
-
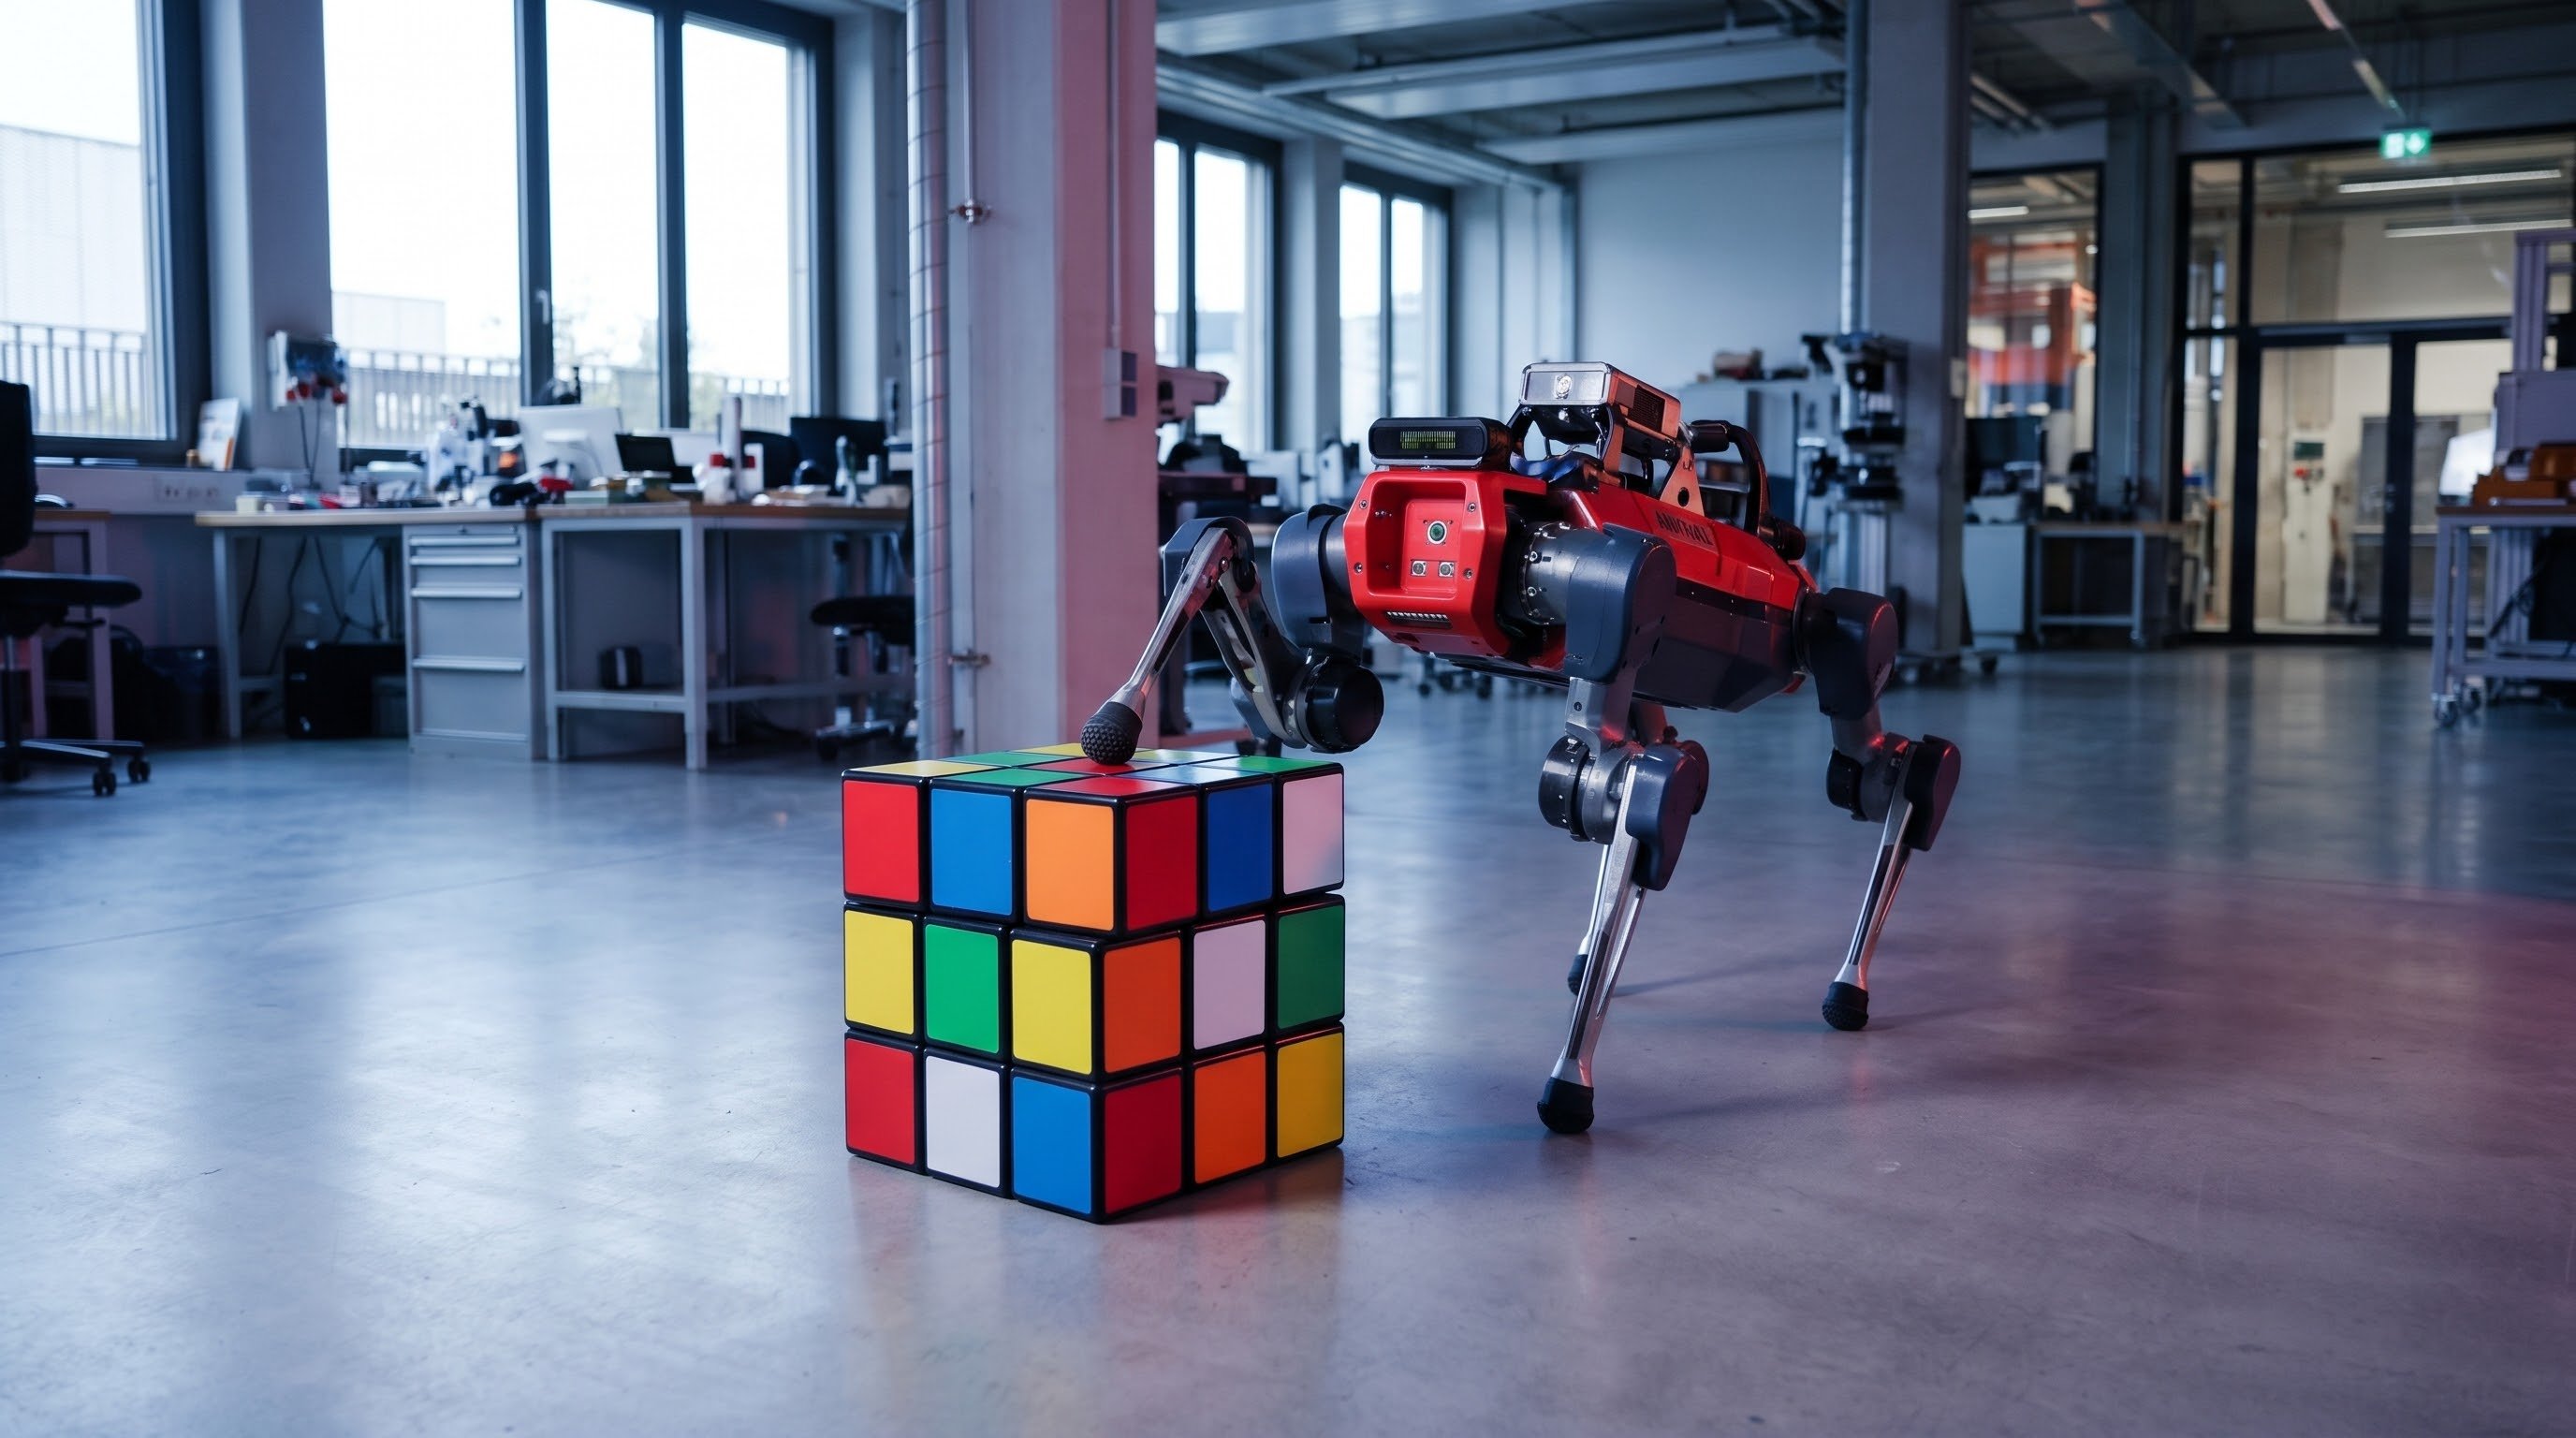
Vierpotige robot lost reuzen-Rubiks kubus op met alleen zijn poten
Onderzoekers van ETH Zürich en Nvidia leerden een vierpotige inspectierobot een reuzen-Rubiks kubus op te lossen met alleen zijn poten. Hij kantelt de kubus en draait de lagen, zonder hulp van mensen. Alle drie de pogingen lukten, elk in acht tot negen minuten.
-
Mensachtige robot uit Zuid-Korea duwt 35 kilo en tilt 20 kilo, terwijl hij loopt
Onderzoekers van KAIST in Zuid-Korea lieten hun mensachtige robot tijdens het lopen voorwerpen tot 35 kilo duwen en tot 20 kilo tillen. Benen en armen worden door één AI-systeem samen aangestuurd. Het is een demonstratie in het lab; meer tests volgen.
-
Menselijk hersenweefsel uit het lab leert met een AI-coach een virtuele stok te balanceren
Op een bijeenkomst in Silicon Valley liet een team van UC Santa Cruz zien hoe gekweekt menselijk hersenweefsel een klassieke besturingstaak leert: een stok rechtop houden op een karretje. Een AI-algoritme is de coach. Een vrijwilliger met een toetsenbord kon het weefsel nauwelijks bijhouden.
-
AI haalt goudniveau op de Internationale Wiskunde-Olympiade
Een geavanceerde versie van Google Gemini loste vijf van de zes opgaven van de Wiskunde-Olympiade op en kwam op 35 van de 42 punten. De organisatie beoordeelde de antwoorden zelf. Vorig jaar haalde AI nog zilver, en pas na dagen rekenen.
-
Chinees DeepSeek brengt redeneermodel R1 uit dat iedereen mag downloaden
Het Chinese DeepSeek publiceert R1, een AI-model dat volgens het bedrijf op het niveau van OpenAI's o1 redeneert. Het model is vrij te downloaden en te gebruiken. Zo wordt sterke AI breder beschikbaar, buiten de grote Amerikaanse bedrijven om.
-
OpenAI toont o1, een AI-model dat eerst nadenkt voordat het antwoordt
OpenAI brengt o1-preview uit, een model dat vóór het antwoord een lange gedachtegang opschrijft. Daardoor lost het veel moeilijkere wiskunde- en programmeeropgaven op dan ChatGPT tot nu toe. Het kost wel meer rekentijd.